AlexNet என்றால் என்ன? Deep Learning எப்படி வந்தது? CUDA வின் பங்கு என்ன?
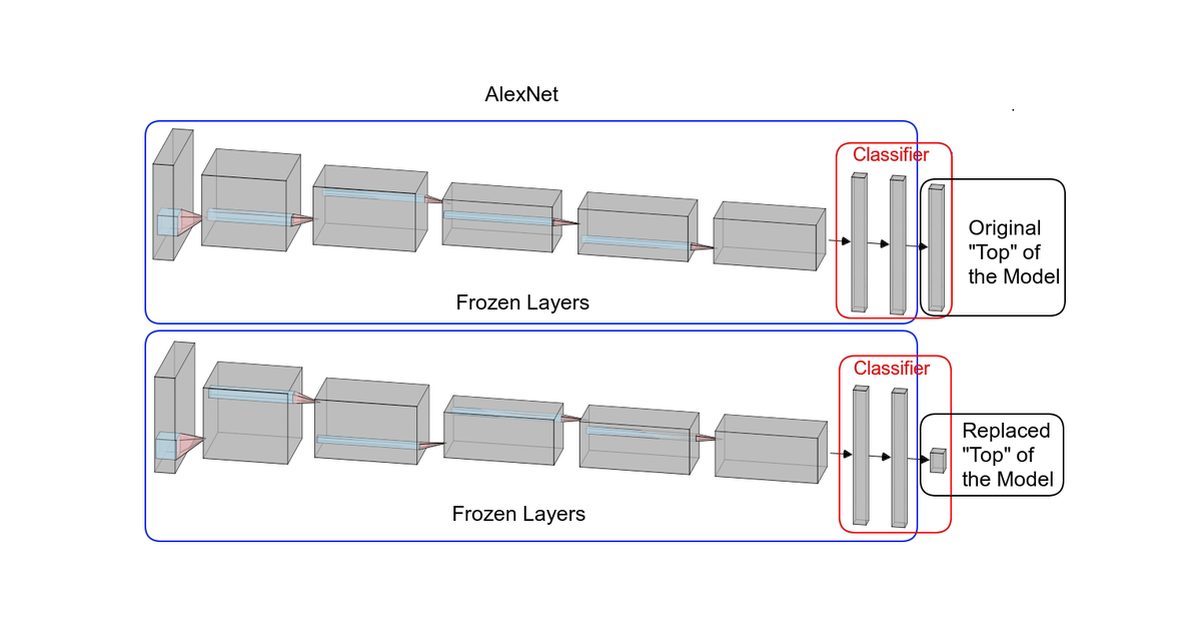
AlexNet அடுக்குகளை அடிப்படையாகக் கொண்ட convolutional வலையமைப்பின் வரைபடம் (classifier மாற்றப்பட்டது); விளக்கப் படம், 2012 மூலக் கட்டமைப்பு அல்ல. வரைபடம்: Daniel Voigt Godoy, CC BY 4.0, Wikimedia Commons வழியாக.
அறிமுகம்: AlexNet என்றால் என்ன, 2012 ஏன் இன்னும் முக்கியம்?
2012ம் ஆண்டு செப்டெம்பர் மாதம், டொராண்டோ பல்கலைக்கழகத்தை (University of Toronto) சேர்ந்த மூன்று ஆராய்ச்சியாளர்கள் உருவாக்கிய ஒரு கணினி நிரல், அதுவரை எந்த இயந்திரமும் செய்யாத ஒரு காரியத்தைச் செய்தது. அது முன்பு பார்த்திராத புகைப்படங்களை - பூனைகள், மகிழுந்துகள், காளான்கள், கலங்கரை விளக்கங்கள், 120 வகை நாய் இனங்கள் - பார்த்து, உலகின் மிகப்பெரிய தொழில்நுட்ப நிறுவனங்கள் உருவாக்கிய எந்த அமைப்பையும் விட மிக அதிக துல்லியத்துடன் அவற்றில் என்ன இருக்கிறது என்று பெயரிட்டது. அந்த நிரலின் பெயர் AlexNet. அதன் பிழை விகிதம் (error rate) 15.3 விழுக்காடு. அதே போட்டியில் இரண்டாம் இடம் பெற்ற அமைப்பு 26.2 விழுக்காடு நேரம் தவறு செய்தது. இத்தகைய பெரிய இடைவெளி சாதாரண முன்னேற்றமாகத் தோன்றவில்லை; அது வேறுவிதமான ஒரு இயந்திரமாகவே தோன்றியது - ஒரு வகையில் அது உண்மையும் கூட. அந்த இயந்திரம் எங்கிருந்து வந்தது என்பதே இக்கட்டுரையின் கதை: பல தசாப்தங்கள் பழமையான நியூரல் நெட்வொர்க் (Neural Network) என்ற கருத்து, டீப் லேர்னிங் (Deep Learning) என்ற கணித முறை, நியாயமான போட்டியைச் சாத்தியமாக்கிய படத் தரவுத்தளம், அத்துடன் ஒரு graphics வன்பொருளும் அதைத் திறந்த CUDA என்ற மென்பொருள் தளமும் - இவை இல்லாமல் 2012இல் இது எதுவும் நடந்திருக்காது.
1. Neural Network: தனது காலத்துக்குக் காத்திருந்த பழைய கருத்து
AlexNet-இன் அடிப்படைக் கருத்து, அது வெற்றி பெற்றபோது உயிருடனிருந்த பெரும்பாலான கணினிகளைவிடப் பழமையானது. 1943இல் Warren McCulloch, Walter Pitts ஆகியோர் மூளையின் கலத்துக்கு ஒரு கணித மாதிரியை முன்மொழிந்தார்கள் - சமிக்ஞைகளைப் பெற்று, அவற்றைக் கூட்டி, மொத்தம் ஒரு வாயிலை (threshold) கடந்தால் சுட்டெரிக்கும் ஒரு அலகு. 1958இல் Frank Rosenblatt இதை Perceptron என்ற இயந்திரமாக மாற்றினார்; ஒவ்வொரு தவறுக்கும் பின்னர் தனது இணைப்புகளின் வலிமையை மாற்றிக் கற்றுக்கொள்ளும் இயந்திரம் அது. எதிர்பார்ப்பு மிகப் பெரிதாக இருந்தது; ஆயுள் மிகக் குறுகியதாக இருந்தது. 1969இல் Marvin Minsky, Seymour Papert ஆகியோர், ஒற்றை அடுக்கு (single-layer) Perceptron சில அடிப்படை logic செயல்பாடுகளைக் கூடக் கற்க முடியாது என்று நிரூபித்தனர். Neural network ஆராய்ச்சிக்கான நிதி உடைந்தது; துறை தனது முதல் நீண்ட குளிர்காலத்தில் (AI winter) நுழைந்தது.
அதை மீண்டும் உயிர்ப்பித்தது, ஒன்றுக்கு மேற்பட்ட அடுக்குகள் கொண்ட நெட்வொர்க்குகளைப் பயிற்றுவிக்கும் முறை. 1986இல் David Rumelhart, Geoffrey Hinton, Ronald Williams ஆகியோர் backpropagation முறையைப் பரப்பினார்கள் - நெட்வொர்க்கின் பிழையை எடுத்து, ஒவ்வொரு அடுக்கிலும் பின்னோக்கித் தள்ளி, ஒவ்வொரு இணைப்பும் அந்தத் தவறுக்கு எவ்வளவு பங்களித்தது என்று துல்லியமாகச் சொல்லும் முறை அது. பல அடுக்கு நெட்வொர்க்குகளுக்கு இப்போது, தத்துவ அளவில், எதையும் கற்க முடியும். 1989இலும் 1990களிலும் Bell Labs-இல் Yann LeCun, வங்கிக் காசோலைகளில் கையெழுத்து இலக்கங்களைப் படித்த LeNet என்ற convolutional neural network (CNN)-ஐ உருவாக்கினார்; அது வணிக ரீதியாகப் பயன்படுத்தப்பட்டது. 1997இல் Sepp Hochreiter, Jurgen Schmidhuber ஆகியோர் தொடர்களுக்காக LSTM (Long Short-Term Memory)-ஐ அறிமுகப்படுத்தினர். கணிதம் வேலை செய்தது. வேலை செய்யாதது வன்பொருள்: சுவாரஸ்யமான அளவுக்கு ஆழமான நெட்வொர்க்குகளைப் பயிற்றுவிக்க அக்காலத்தின் CPU (Central Processing Unit) களுக்கு வாரங்கள் தேவைப்பட்டன; ஆகவே சோதனைகள் சிறியதாகவே இருந்தன, சிறிய நெட்வொர்க்குகளும் கையால் வடிவமைக்கப்பட்ட மாற்று முறைகளிடம் தொடர்ந்து தோற்றன. 2006இல் Hinton அவர்களும் அவரது சகாக்களும் ஆழமான நெட்வொர்க்குகளை அடுக்கடுக்காகப் பயிற்றுவிக்க முடியும் என்று காட்டி, "Deep Learning" என்ற நவீனப் பெயரைச் சூட்டினர். கருத்து தனது பெயரைக் கண்டுவிட்டது. இன்னும் அதன் இஞ்சின் தேவைப்பட்டது.
2. காணாமல் போன இஞ்சின்: GPU-வும் CUDA-வும்
ஒரு neural network-ஐப் பயிற்றுவித்தல் என்பது, அடிப்படையில், ஒரே செயல் பில்லியன் முறை மீள்வதுதான்: பெரிய எண் கட்டங்களைப் (matrices) பெருக்கி, விடைகளைக் கூட்டல். CPU என்பது சில சிக்கலான காரியங்களை ஒன்றன் பின் ஒன்றாக மிக வேகமாகச் செய்ய வடிவமைக்கப்பட்டது. GPU (Graphics Processing Unit) என்பது நேர்மாறான பிரச்சினைக்காக வடிவமைக்கப்பட்டது - ஒரே நேரம் திரையில் மில்லியன் pixels-களுக்கு நிறம் தருவது; ஆகவே அதில் ஒரே சமயம் வேலை செய்யும் நூற்றுக்கணக்கான சிறிய arithmetic அலகுகள் உள்ளன. Pixel shading-ம் neural network பயிற்சியும் ஒரே வகைக் கணிதம் என்று ஆயிற்று.
இதை ஆராய்ச்சியாளர்கள் முன்னரே அறிந்திருந்தார்கள்; ஆனால் graphics அல்லாத வேலைக்கு graphics card-ஐ நிரல்படுத்துவது வேதனையாக இருந்தது. Code-ஐ வரைதல் கட்டளைகளாக (drawing commands) மாறுவேடமிட வேண்டியிருந்தது. முன்னேற்றம் NVIDIA-விடமிருந்து வந்தது. 2000இல் Stanford University-இல் Ian Buck-ம் அவரது சிறு குழுவும் GPU-கள் பொதுநோக்கு நிரல்களை (general-purpose programs) இயக்க முடியும் என்று ஆராயத் தொடங்கியிருந்தனர்; பின்னர் NVIDIA-வில் சேர்ந்த Buck, 2006 நவம்பர் 8ம் திகதி GeForce 8800-உடன் CUDA (Compute Unified Device Architecture)-ஐ வெளியிட்டார் - GPU-வின் நூற்றுக்கணக்கான cores-ஐ, எதையும் வரைவது போல நடிக்காமல் நேரடியாகப் பயன்படுத்த அனுமதித்த முதல் C-அடிப்படை நிரலாக்க சூழல் அது. இயற்பியல், வேதியியல், நிதித்துறை அறிவியலாளர்கள் ஒரே ஆண்டில் அதைத் தழுவினர். இயந்திரக் கற்றலில் (machine learning), டொராண்டோ பல்கலைக்கழக மாணவர் Alex Krizhevsky, நுகர்வோர் graphics card-களில் சிறிய convolutional network-களைப் பயிற்றுவிக்க CUDA code எழுதத் தொடங்கினார்; 2010இல் CNN பயிற்சிக்கான வேகமான CUDA செயலாக்கமான cuda-convnet-ஐ எல்லோருக்கும் இலவசமாக வெளியிட்டார். 2012 வரும்போது, எல்லாத் துண்டுகளும் ஒரே ஆய்வுகூடத்தில் இருந்தன: Hinton-இன் deep learning கணிதம், Krizhevsky-இன் CUDA code, அத்துடன் வாதத்தைத் தீர்க்கும் அளவுக்குப் பெரிய ஒரு போட்டி.
3. ImageNet: போட்டியை நியாயமாக்கிய சோதனை
தசாப்தங்களாக, பார்வை (vision) ஆராய்ச்சியாளர்கள் பொதுவான அளவுகோல் இல்லாமல் முறைகளைப் பற்றி வாதிட்டனர். Fei-Fei Li அவர்களும் அவரது குழுவும் 2007இல் தொடங்கி 2009இல் வெளியிட்ட ImageNet திட்டம் அதை மாற்றியது: பல்லாயிரக்கணக்கான வகைகளில் ஒழுங்குபடுத்தப்பட்ட, 14 மில்லியனுக்கும் மேற்பட்ட label செய்யப்பட்ட படங்களின் தரவுத்தளமாக அது வளர்ந்தது. 2010 முதல், அதன் ஒரு பகுதியில் ImageNet Large Scale Visual Recognition Challenge (ILSVRC) என்ற வருடாந்திரப் போட்டி நடந்தது: 1,000 வகைகள், சுமார் 1.2 மில்லியன் பயிற்சிப் படங்கள் (training images), அத்துடன் top-5 error rate என்ற முதன்மை அளவீடு - சரியான label நிரலின் முதல் ஐந்து ஊகங்களுக்குள் வராத test படங்களின் விழுக்காடு. ஐந்து ஊகங்கள் தாராளமாகத் தோன்றலாம்; ஆனால் வகைகளில் 120 நாய் இனங்கள் மட்டும் உள்ளன, பல புகைப்படங்களில் பல பொருட்கள் உள்ளன. 2010இல், கையால் உருவாக்கப்பட்ட features-ம் SVM (Support Vector Machine)-ம் கொண்ட உலகின் சிறந்த அமைப்பு, சரியான விடையைத் தனது முதல் ஐந்துக்குள் 72 விழுக்காடு நேரம் மட்டுமே கொண்டுவந்தது: சுமார் 28.2 விழுக்காடு பிழை விகிதம். 2011இல் வெற்றியாளர் சுமார் 25.8 விழுக்காட்டுக்கு மேம்படுத்தினார் (மேம்படுத்தல் - improvement). முன்னேற்றம் உண்மைதான்; ஆனால் அது ஒற்றை விழுக்காட்டுப் புள்ளிகளில் அளவிடப்பட்டது.
4. AlexNet: அந்த இயந்திரம் உண்மையில் என்ன?
Krizhevsky, Ilya Sutskever, Hinton ஆகியோர் உருவாக்கி, முதல் ஆசிரியரின் பெயரால் அழைக்கப்பட்ட AlexNet, அதுவரை யாரும் துணியாத அளவிலான ஒரு ஆழமான convolutional neural network. அதில் 60 மில்லியன் மாற்றக்கூடிய parameters-ம் 650,000 செயற்கை neurons-ம், ஐந்து convolutional layers-ஐத் தொடர்ந்து மூன்று fully connected layers-ஆக ஒழுங்கமைக்கப்பட்டிருந்தன; இறுதியில் ஒவ்வொரு வகைக்கும் probability தரும் 1,000-வழி softmax. அதன் அளவைப் போலவே அதற்குள்ளான பல தேர்வுகளும் முக்கியமானவை:
- ReLU (Rectified Linear Unit) neurons. ஆழமான மாதிரிகளில் கற்றலைத் தடைப்படுத்தும் பழைய saturating செயல்பாடுகளுக்குப் பதிலாக, நேர்மறை மதிப்புகளை அப்படியே அனுப்பி எதிர்மறை மதிப்புகளை சுழியமாக்கும் ReLU-கள், இவ்வளவு ஆழமான நெட்வொர்க்கை பல மடங்கு வேகமாகப் பயிற்றுவிக்க அனுமதித்தன.
- Dropout. பயிற்சியின் போது, மிகப்பெரிய இரண்டு layers-இல் உள்ள neurons-இல் பாதி ஒவ்வொரு முறையும் randomly நிறுத்தப்பட்டன; நெட்வொர்க் நொறுங்கும் தற்செயல்பாடுகளைச் சார்ந்திருக்காமல் இது கட்டாயப்படுத்தியது. Overfitting-ஐ இது பெரிதும் குறைத்தது.
- Data augmentation. 1.2 மில்லியன் பயிற்சிப் படங்கள், வெட்டுதல் (cropping), பல்டியடித்தல் (flipping), நிறங்களைச் சிறிது மாற்றுதல் மூலம் பல மடங்காகப் பெருக்கப்பட்டன; ஆகவே நெட்வொர்க் புகைப்படங்களை மனப்பாடம் செய்யாமல், பொருட்கள் எப்படி இருக்கும் என்று கற்றுக்கொண்டது.
- இரண்டு GPU-கள். நெட்வொர்க் ஒரு card-இல் அடங்காத அளவுக்குப் பெரிதாக இருந்ததால், தலா 3 GB நினைவகம் கொண்ட இரண்டு NVIDIA GeForce GTX 580 card-களில் அது பிரிக்கப்பட்டது; ஒவ்வொரு card-ம் பாதி neurons-ஐ இயக்கியது, தேர்ந்தெடுக்கப்பட்ட layers-இல் இரு பாதிகளும் தகவல் பரிமாறிக்கொண்டன.
| AlexNet ஒரு பார்வையில் | |
|---|---|
| ஆசிரியர்கள் | Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton (University of Toronto) |
| கட்டமைப்பு (Architecture) | 5 convolutional layers + 3 fully connected layers |
| Parameters | 60 மில்லியன் |
| Neurons | 650,000 |
| பயிற்சித் தரவு | 1.2 மில்லியன் ImageNet படங்கள், 1,000 வகைகள் |
| வன்பொருள் (Hardware) | 2 x NVIDIA GeForce GTX 580 (3 GB), CUDA |
| பயிற்சிக் காலம் | 5 முதல் 6 நாட்கள் |
| ILSVRC-2012 top-5 error | 15.3% (வெற்றியாளர்); இரண்டாம் இடம் 26.2% |
5. CUDA-வின் பங்கு: Performance ஏன் வெற்றியின் வித்தியாசம்?
AlexNet-க்குள்ளிருந்த கருத்துகள் எதுவும் இரகசியமல்ல. Convolutional network-கள் 23 வருடங்கள் பழமையானவை. ReLU-வும் dropout-ம் வெளியிடப்பட்ட ஆராய்ச்சியிலிருந்து வந்தவை. Krizhevsky-ம் அவரது சகாக்களும் வேறு யாரும் செய்யாதது ஒன்றைச் செய்தார்கள்: இந்த அளவிலான நெட்வொர்க்கை, இந்த அளவிலான தரவில் பயிற்றுவித்தார்கள் - அது வேறு எதையும் விட முன்னர் ஒரு performance சாதனை. சில நூறு டொலர்களுக்குக் கிடைத்த gaming card-ஆன GTX 580, ஒரு நொடிக்கு ஒரு trillion floating-point operations அளவுக்கு (TFLOPS) செயல்திறன் தந்தது; அக்காலத்தின் உயர்தர CPU பத்துக் கோடிகளில் (tens of billions) மட்டுமே தந்தது. CNN பயிற்சியில் ஆதிக்கம் செலுத்தும் matrix arithmetic-க்கு இது சிறிய நன்மையல்ல. இரண்டு GPU-களில் AlexNet ஐந்து முதல் ஆறு நாட்களில் முடித்த, 1.2 மில்லியன் படங்கள் மீதான 90 பயிற்சிச் சுற்றுகள் (epochs), அக்காலத்தின் CPU-களில் மாதங்கள் எடுத்திருக்கும் - அந்தச் சோதனையை ஒருபோதும் இயக்க முடியாத அளவுக்கு, மெதுவாக மீண்டும் மீண்டும் மேம்படுத்தி வெல்லும் அளவுக்கு நிச்சயம் இயக்க முடியாத அளவுக்கு நீளமான காலம்.
இந்த வேலைக்கு அந்த card-ஐப் பயன்படக்கூடியதாக மாற்றியது CUDA. நெட்வொர்க்கின் கணித இதயமான convolution-ஐயே மிகவும் மேம்படுத்தப்பட்ட (highly tuned) CUDA code-ஆக Krizhevsky-இன் cuda-convnet நூலகம் (library) செயல்படுத்தியது; மற்றவர்களும் இச்சாதனையை மீள முடியுமாறு குழு அதைப் பொதுவில் வெளியிட்டது. அதைவிட முக்கியமாக, இரண்டு GPU பிரிப்பு முன்னோக்குப் பாதையைக் காட்டியது: வேலையும் தரவும் card-களுக்கிடையே எப்படி நகர வேண்டும் என்பதை நிரலாளர்கள் துல்லியமாகக் கட்டுப்படுத்த CUDA அனுமதித்ததால், ஒரு GPU-வில் அடங்காத மாதிரியையும் பயிற்றுவிக்க முடிந்தது. பெரிய மாதிரிகளைப் பல GPU-களில் பிரிப்பது என்ற அந்தப் பாடம்தான் இன்று பூமியிலுள்ள ஒவ்வொரு பெரிய AI அமைப்பின் அடித்தளம். AlexNet வேகமாகச் செல்ல CUDA-ஐப் பயன்படுத்தவில்லை. 1986 முதல் deep learning காத்திருந்தது CUDA-தரப்பு இணையான கணித்தலுக்கே (parallel computing) என்பதை அது நிரூபித்தது.
6. வாதத்தை முடித்துவைத்த முடிவு
2012 ஒக்டோபரில் ஃபுளொரன்ஸில் நடந்த workshop-இல் ILSVRC-2012 முடிவுகள் அறிவிக்கப்பட்டபோது, அறை உடனே புரிந்துகொண்டது. AlexNet-இன் 15.3 விழுக்காடு top-5 error, இரண்டாம் இடத்தின் 26.2 விழுக்காட்டுக்கு எதிரான விளிம்பல்ல; துறையின் சிறந்த மூளைகள் ஒற்றைப் புள்ளிகளுக்காகப் போராடிய ஒரு தசாப்தத்துக்குப் பின்னர், கிட்டத்தட்ட பதினொரு புள்ளிகளின் பள்ளம் அது. டொராண்டோ குழு 2010 தரவிலும் பங்கேற்று, அங்கும் முந்தைய சிறந்த முடிவைத் தாண்டியிருந்தது (முந்தைய சிறந்தது 28.2 விழுக்காடு இருக்க, top-5 error 17.0 விழுக்காடு). ஆராய்ச்சிச் சமூகத்தில் அதன் விளைவு உடனடியானது. 2013இல், போட்டியின் கிட்டத்தட்ட ஒவ்வொரு தீவிரமான பங்கேற்பும் ஒரு ஆழமான convolutional network-ஆகவே இருந்தது. 2014 வாக்கில் GoogLeNet பிழையை 6.7 விழுக்காட்டுக்குக் கொண்டுவந்தது; 2015இல் Microsoft-இன் ResNet 3.57 விழுக்காட்டை எட்டியது - இந்த அளவீட்டில், கவனமான மனித label செய்பவரை விடச் சிறந்த முடிவு அது.
| வருடம் | ILSVRC வெற்றியாளர் | முறை (Approach) | Top-5 error |
|---|---|---|---|
| 2010 | NEC-UIUC | கையால் உருவாக்கப்பட்ட features + SVM | 28.2% |
| 2011 | Xerox Research (XRCE) | மேம்படுத்தப்பட்ட features + SVM | 25.8% |
| 2012 | SuperVision (AlexNet) | CUDA-உடன் GPU-களில் பயிற்றுவிக்கப்பட்ட ஆழமான CNN | 15.3% |
| 2013 | Clarifai (ZFNet) | ஆழமான CNN | 11.2% |
| 2014 | GoogLeNet | ஆழமான CNN (22 layers) | 6.7% |
| 2015 | ResNet (Microsoft Research) | ஆழமான CNN (152 layers) | 3.57% |
7. பின்னர் நடந்தது
விளைவுகள் எல்லாத் திசைகளிலும் பரவின. 2013இல் டொராண்டோ குழுவின் சிறு நிறுவனமான DNNresearch-ஐ Google கையகப்படுத்தியது; deep learning ஆராய்ச்சி ஓரத்திலிருந்து தொழில்துறையின் மையத்துக்கு நகர்ந்தது: speech recognition, machine translation, medical imaging, recommendation systems, self-driving ஆராய்ச்சி - இவை அனைத்தும் சில வருடங்களுக்குள் GPU-இல் பயிற்சி பெற்ற நெட்வொர்க்குகளில் மீண்டும் கட்டப்பட்டன. Krizhevsky-இன் cuda-convnet-ஐத் தொடர்ந்து Caffe, Torch, TensorFlow, PyTorch போன்ற framework-கள் வந்தன; அவை கிட்டத்தட்ட அனைத்தும் NVIDIA-வின் CUDA தளத்திலும் 2014இல் வெளியான அதன் cuDNN deep learning நூலகத்திலும் கட்டப்பட்டவை. வன்பொருள் இரண்டு gaming card-களிலிருந்து பல்லாயிரக்கணக்கான GPU-கள் கொண்ட data centre-களாக உயர்ந்தது; மாதிரிகள் 60 மில்லியன் parameters-இலிருந்து நூற்றுக்கணக்கான பில்லியன்களுக்கு வளர்ந்தன. இன்று தலைப்புச் செய்திகளிலுள்ள ஒவ்வொரு பெரிய AI அமைப்பும் - அதை உருவாக்கிய நிறுவனம் எதுவாயினும் - 2012இல் செய்யப்பட்ட நிரூபணத்தின் வழித்தோன்றலே: மிக ஆழமான ஒரு neural network, மிகப் பெரிய தரவுத்தளத்தில், CUDA மூலம் நிரல்படுத்தப்பட்ட இணையான வன்பொருளில் பயிற்சி பெற்றால், ஒரு துறை நம்புவது சாத்தியம் என்ன என்பதையே மாற்றும் அளவுக்கு வேறெல்லாவற்றையும் விட மேலாகச் செயல்படும் என்பதே அது.
முடிவுரை
Deep learning வந்த தருணமாக AlexNet நினைவுகூரப்படுகிறது; ஆனால் அதை மிகத் துல்லியமாகச் சொன்னால், மூன்று தனி வரலாறுகள் ஒன்றுசேர்ந்த தருணம் என்று சொல்லலாம். 1943இன் கருத்தான neural network, ஒரு பயிற்சி முறைக்காகத் தசாப்தங்கள் காத்திருந்தது; 1986இன் backpropagation, கணினித் திறனுக்காகத் தசாப்தங்கள் காத்திருந்தது; 2006இன் CUDA, தனது மிக முக்கியமான வாடிக்கையாளர் artificial intelligence என்று அறியாமல் பொது அறிவியலுக்காகக் கட்டப்பட்டிருந்தது. ஒரு மாணவரின் gaming graphics card-கள் ஒரு மில்லியன்-படத் தரவுத்தளத்தையும் அறுபது வருடக் கணிதத்தையும் சந்தித்தபோது, வந்த முடிவு பூமியின் சிறந்த அமைப்புகளைப் பதினொரு புள்ளிகளால் வென்று, ஒரே பிற்பகலில் ஒரு அறிவியல் வாதத்தைத் தீர்த்துவைத்தது. அதற்குப் பின் வந்த எல்லாமே - ஒவ்வொரு chatbot-ம், ஒவ்வொரு மொழிபெயர்க்கப்பட்ட வாக்கியமும், இயந்திரம் பார்க்கும் ஒவ்வொரு படமும் - 2012இன் பாடத்தில்தான் இயங்குகிறது: பெரிய நெட்வொர்க்குகள், பெரிய தரவு, பெரிய அளவிலான இணையான வன்பொருள். அந்த மூன்று சொற்கள் முதன்முதலில் சந்தித்த இடம் AlexNet.