AlexNet உம் ImageNet உம்: Deep Learning இன் பிறப்பு
- Fei-Fei Li, WordNet, மற்றும் Mechanical Turks
- ImageNet
- AlexNet
- AlexNet செயலில்
- மூலங்கள் (Resources)
இன்றைய deep learning புரட்சி 2012 ஆம் ஆண்டு செப்டம்பர் 30 ஆம் திகதிக்குப் போய் முடிகிறது. அந்த நாளில் AlexNet என்ற Convolutional Neural Network (CNN) ImageNet 2012 போட்டியில் வெற்றி பெற்றது [1]. AlexNet வெறுமனே வெற்றி பெறவில்லை; அது போட்டியையே ஆதிக்கம் செலுத்தியது.
AlexNet மற்றப் போட்டியாளர்களைப் போல இருக்கவில்லை. அன்றைய காலத்தின் மிகப் பெரிய படத் தரவுத்தொகுதியான ImageNet மீது இந்தப் புதிய model ஒப்பற்ற செயல்திறனைக் காட்டியது. இந்த நிகழ்வின் மூலம் AlexNet, deep learning இன் முதலாவது பரவலாக ஏற்றுக்கொள்ளப்பட்ட வெற்றிகரமான பயன்பாடாக மாறியது. அடுத்த நெருங்கிய போட்டியாளரை விட 9.8 சதவீதப் புள்ளிகள் முன்னணியில் இருந்ததால் அது எல்லோரினதும் கவனத்தையும் ஈர்த்தது [2].
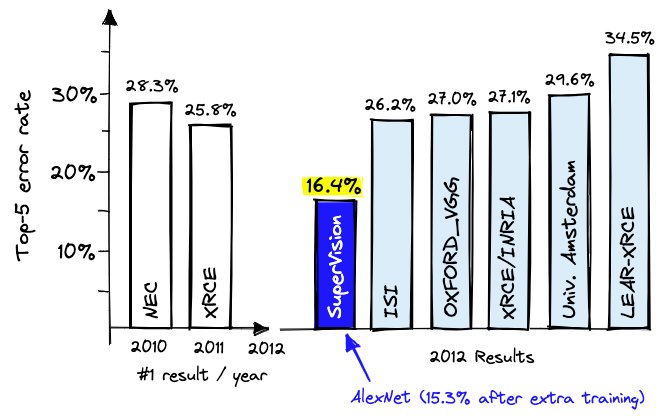
இதுவரை deep learning ஒரு நல்ல யோசனை என்றாலும் நடைமுறைக்கு உதவாது என்றே பெரும்பாலானோர் கருதினர். deep learning வெறும் பகற்கனவு அல்ல என்பதை AlexNet காட்டியது; அதை நடைமுறைக்குக் கொண்டுவருவது எப்படி என்பதையும் அதன் ஆசிரியர்கள் உலகுக்குக் காட்டினர். ஆனாலும் அதன் பின் ஏற்பட்ட deep learning எழுச்சிக்கு AlexNet மட்டுமே காரணம் அல்ல. உண்மையில், பெரிய ImageNet தரவுத்தொகுதி இல்லாவிட்டால் AlexNet உம் இருந்திருக்காது.
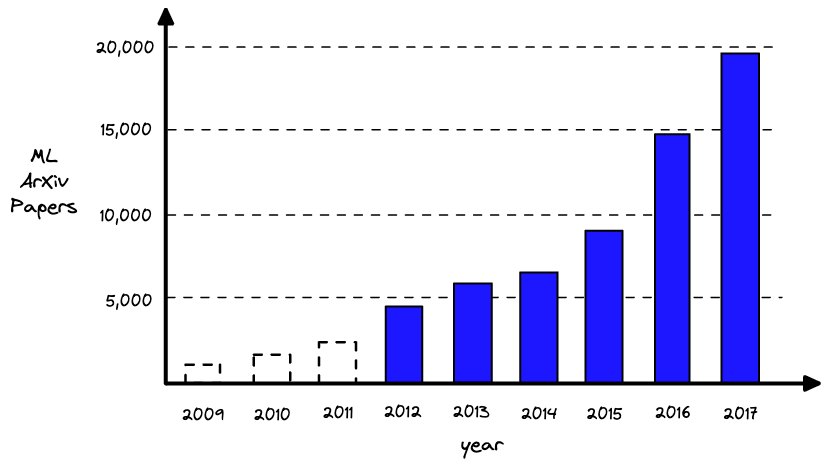
AI இன் எதிர்காலம், ImageNet போட்டி அமைத்த அடித்தளத்தின் மீதும், ImageNet க்கும் AlexNet க்கும் இடையிலான இணைவைச் சாத்தியமாக்கிய புதிய தீர்வுகளின் மீதும் கட்டியெழுப்பப்பட இருந்தது.
Fei-Fei Li, WordNet, மற்றும் Mechanical Turks
2006 ஆம் ஆண்டில் computer vision துறை போதிய நிதி இல்லாத, கவனிப்பு குறைந்த துறையாகவே இருந்தது. ஆனாலும் பல ஆய்வாளர்கள் சிறந்த model களை உருவாக்குவதிலேயே கவனம் செலுத்தினர். ஆண்டுதோறும் முன்னேற்றம் இருந்தது; ஆனால் அது மெதுவாகவே இருந்தது.
Fei-Fei Li தனது Computer Vision பிஎச்.டி படிப்பை Caltech இல் [4] முடித்துவிட்டு, University of Illinois Urbana-Champaign இல் கணினி அறிவியல் பேராசிரியராகப் பணியைத் தொடங்கியிருந்தார். அந்தக் காலத்தில் model களில் மட்டுமே கவனம் செலுத்தப்படுவதையும், அதன் விளைவாகத் தரவுகளில் கவனம் இல்லாமல் இருப்பதையும் Li அவதானித்தார்.
உண்மை உலகின் பன்முகத்தன்மையைப் பிரதிபலிக்கும் பெரிய தரவுத்தொகுதிகளே model இன் செயல்திறனை மேம்படுத்தும் திறவுகோலாக இருக்கலாம் என்று Li நினைத்தார்.
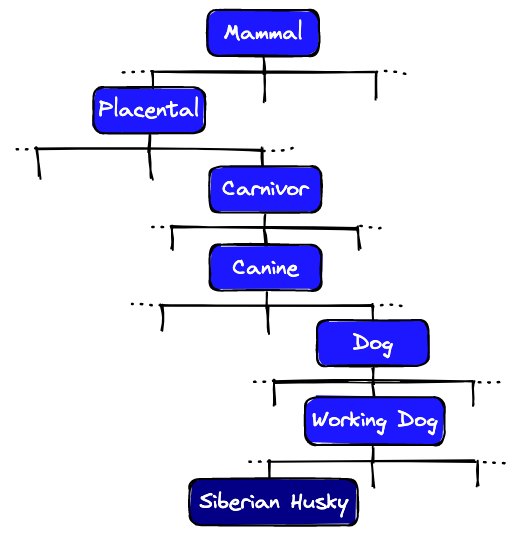
தரவுத்தொகுதிகள் பற்றிய தனது ஆய்வின்போது, 1980 களில் உருவாக்கப்பட்ட WordNet என்ற தரவுத்தொகுதியின் இணை-உருவாக்குநரான பேராசிரியர் Christiane Felbaum பற்றி Li அறிந்துகொண்டார். WordNet என்பது ஆங்கிலச் சொற்கள் பலவற்றை ontological அமைப்பில் ஒழுங்குபடுத்தியது [5].
2007 இல் Li யும் Felbaum உம் சந்தித்தனர். WordNet இல் உள்ள ஒவ்வொரு சொல்லுக்கும் ஒரு மேற்கோள் படத்தைச் சேர்ப்பது தொடர்பான தனது தற்போதைய வேலையைப் பற்றி Felbaum பேசினார். இது computer vision உலகையே அதிவேகத்துக்குத் தள்ளப்போகும் ஒரு யோசனையைத் தூண்டியது. விரைவிலேயே, அன்றைய காலத்தின் மிகப் பெரிய படத் தரவுத்தொகுதியாக மாறப்போவதை, அதாவது ImageNet ஐ [6], உருவாக்குவதற்காக Li ஒரு குழுவைக் கூட்டினார்.
ImageNet இன் பின்னாலுள்ள யோசனை என்னவென்றால், WordNet ஐ அடிப்படையாகக் கொண்ட படங்களின் பெரிய ontology, மேம்பட்ட உள்ளடக்க அடிப்படையிலான படத் தேடலையும் புரிதலையும் உருவாக்குவதற்கான திறவுகோலாக இருக்கலாம் என்பதே [7].
இரண்டு ஆண்டுகளுக்குப் பின், WordNet ontology க்கு ஏற்ப கட்டமைக்கப்பட்டு லேபிள் இடப்பட்ட 12 மில்லியன் படங்களுடன் ImageNet இன் முதல் பதிப்பு வெளியிடப்பட்டது. ஒருவர் நிமிடத்துக்கு ஒரு படத்தை annotate செய்து, அந்த இரண்டு ஆண்டுகளிலும் வேறு எதுவுமே செய்யாமல் (தூங்குவது, சாப்பிடுவது உட்பட) இருந்திருந்தால், அதற்கு 22 ஆண்டுகள் 10 மாதங்கள் எடுத்திருக்கும்.
இதை இரண்டு ஆண்டுகளுக்குள் செய்து முடிக்க, Li ஆனவர் Amazon Mechanical Turk ஐ நாடினார். இது ஒரு crowdsourcing தளம்; இங்கே யார் வேண்டுமானாலும் உலகம் முழுவதிலுமுள்ள மக்களைக் குறைந்த செலவில் வேலை செய்ய அமர்த்திக்கொள்ளலாம்.
ஒரு படம் ஒரு குறிப்பிட்ட சொல்லை (WordNet ontology யிலிருந்து) குறிக்கிறதா இல்லையா என்பதைத் தீர்மானிக்கும்படி ImageNet குழு “Turkers” க்கு அறிவுறுத்தியது. ஒவ்வொரு படம்-சொல் இணைக்கும் பல Turker மதிப்பெண்கள் பெறுவது உட்பட, annotation சரியாக இருப்பதை உறுதிசெய்ய பல நடவடிக்கைகள் எடுக்கப்பட்டன [7].
வெளியிடப்பட்ட நேரத்தில், பொதுமக்கள் பயன்படுத்தக்கூடிய, லேபிள் இடப்பட்ட படங்களின் உலகின் மிகப் பெரிய தரவுத்தொகுதியாக ImageNet இருந்தது. ஆனாலும் அந்தத் தரவுத்தொகுதி மீது மிகக் குறைந்த ஆர்வமே இருந்தது. CVPR மாநாட்டில் ஒரு poster ஆகக் காட்சிப்படுத்தப்பட்ட பிறகு, ஆர்வத்தைத் தூண்ட அவர்கள் வேறு வழியைக் கண்டுபிடிக்க வேண்டியிருந்தது.
ImageNet
ImageNet ஐ விவரிக்கும் ஆய்வுக் கட்டுரை 2009 இல் வெளியிடப்பட்டபோது, அந்தத் தரவுத்தொகுதி 22,000 வகைகளில் 12 மில்லியன் படங்களைக் கொண்டிருந்தது.
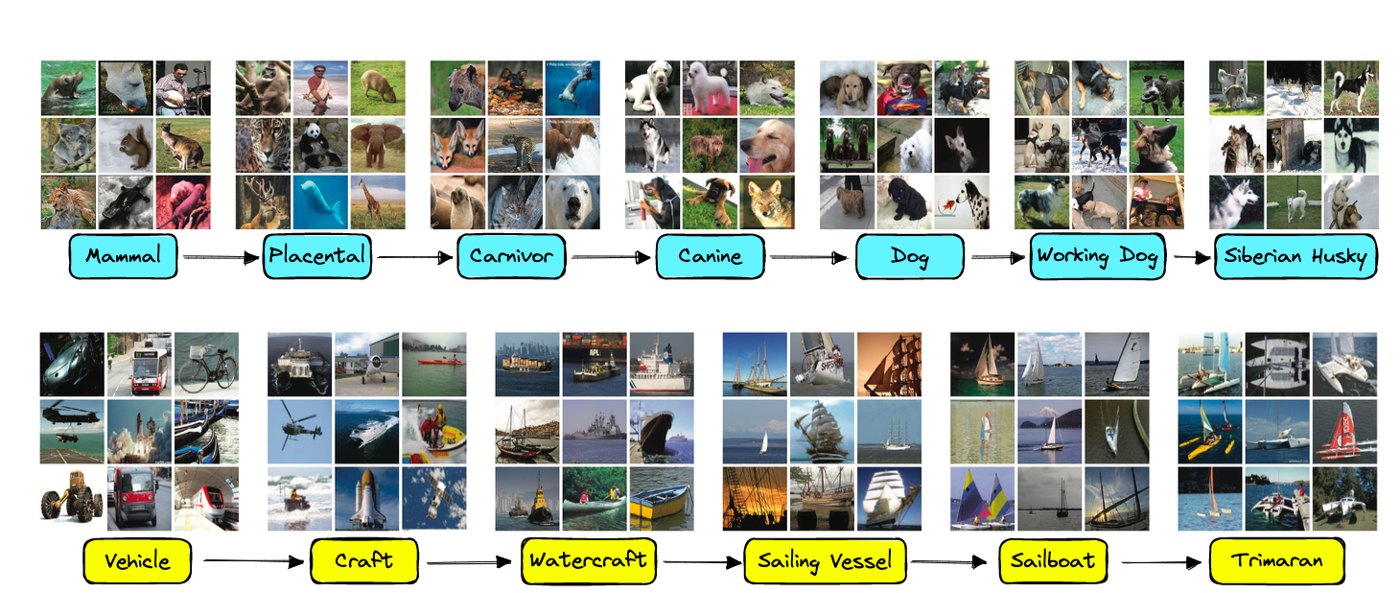
அது WordNet இன் ontological அமைப்பைப் பயன்படுத்தியதால், இந்தப் படங்கள் மேலும் மேலும் பொதுவான வகைகளுக்குள் அடங்கிச் சென்றன.
அந்தக் காலத்தில் வேறு சில படத் தரவுத்தொகுதிகளும் ImageNet போலவே ontological அமைப்பைப் பயன்படுத்தின. அவற்றுள் நன்கு அறியப்பட்ட ஒன்று Extra Sensory Perception (ESP) தரவுத்தொகுதி. அது “ESP game” மூலம் இதேபோன்ற “crowdsourcing” அணுகுமுறையைப் பயன்படுத்தியது. இந்த விளையாட்டில் இரண்டு பங்காளிகள் சொற்களைப் படங்களுடன் பொருத்த முயல்வார்கள்; அதன் மூலம் லேபிள்கள் உருவாகும் [8].
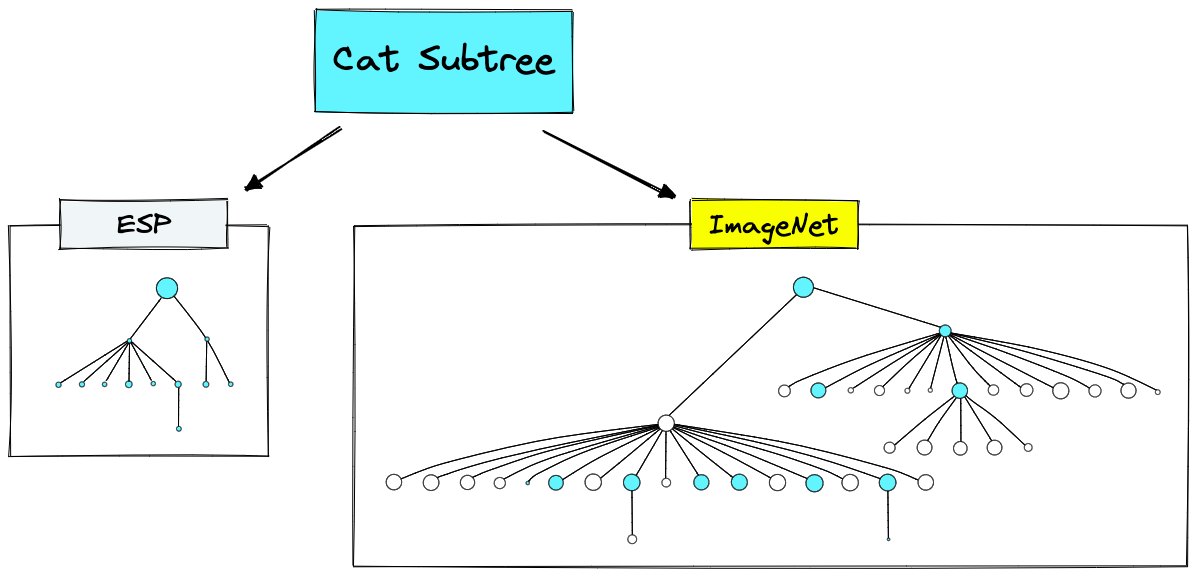
அதிக அளவு தரவு சேகரிக்கப்பட்டிருந்தாலும், தரவுத்தொகுதியின் பெரும்பகுதி பொதுவில் வெளியிடப்படவில்லை [8]. வெளியிடப்பட்ட 60K படங்களில், ImageNet மிகப் பெரிய, அடர்த்தியான உள்ளடக்கத்தை வழங்கியது [7]. அதைவிட, ESP அடிப்படையிலேயே குறைபாடுடையது என்றும் கண்டறியப்பட்டது [9]. Google Image search க்குப் பயன்படுத்தப்பட்ட, மீண்டும் உரிமம் வழங்கப்பட்ட ஒரு பதிப்பைத் [10] தவிர, அது AI துறையில் எந்தத் தாக்கத்தையும் ஏற்படுத்தவில்லை.
ImageNet மீதும், ESP போன்ற ஒத்த தரவுத்தொகுதிகள் மீதும் தொடக்கத்தில் ஆர்வம் குறைவாகவே இருந்தது. அந்தக் காலத்தில் அதிக தரவு இருந்தால் model களின் செயல்திறனை மேம்படுத்தலாம் என்று நம்பியவர்கள் மிகச் சிலரே.
பெரும்பாலான ஆய்வாளர்கள் அந்தத் தரவுத்தொகுதி மிகப் பெரியது, சிக்கலானது என்று நிராகரித்தனர். பின்னோக்கிப் பார்த்தால் இது ஆச்சரியமாகத் தோன்றும். ஆனால் அக்காலத்தில் 12 வகைகள் கொண்ட தரவுத்தொகுதிகளில் கூட model கள் தடுமாறின; அதனால் ImageNet இன் 22,000 வகைகள் அபத்தமாகவே தெரிந்திருக்கும்.
ImageNet Challenge
அடுத்த ஆண்டுக்குள் ImageNet குழு ImageNet Large Scale Visual Recognition Challenge (ILSVRC) ஐ ஏற்பாடு செய்துவிட்டது. போட்டியாளர்கள் ImageNet இன் 1,000 வகைகளுடைய சுருக்கப்பட்ட பட்டியலில் படங்களைச் சரியாக வகைப்படுத்த வேண்டும்; வெவ்வேறு பொருட்களையும் காட்சிகளையும் கண்டறிய வேண்டும். ஒவ்வொரு ஆண்டும் மிகக் குறைந்த error rate கொண்ட model ஐ உருவாக்கிய அணி வெற்றி பெற்றது [2].
தரவுத்தொகுதியின் அளவும் போட்டியின் அளவும் காரணமாக, ILSVRC computer vision இல் முதன்மையான benchmark ஆக மாறியது. அதிக தரவு நல்ல விசயமாக இருக்கலாம் என்பதை ஆய்வாளர்கள் உணர்ந்துகொண்டனர்.
2012 முன்னைய ஆண்டுகளைப் போல இருக்கவில்லை. 2012 செப்டம்பர் 30 அன்று, புதிய ILSVRC முடிவுகள் வெளியிடப்பட்டன. AlexNet என்ற ஒரு model மற்றவற்றிலிருந்து தெளிவாக வேறுபட்டு நின்றது [11].
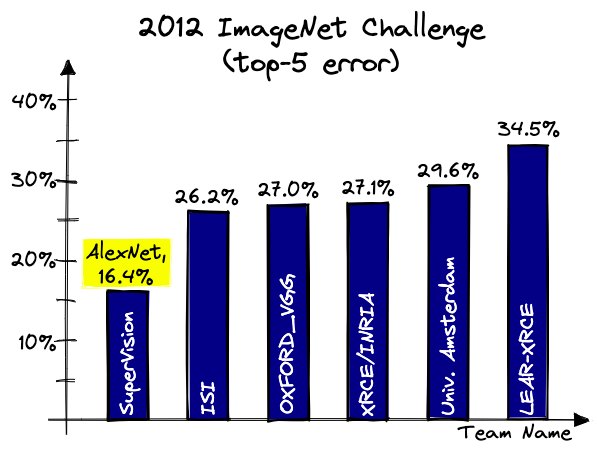
25% க்குக் குறைவான error rate எடுத்த முதல் model AlexNet தான். அடுத்த நெருங்கிய போட்டியாளர் 9.8 சதவீதப் புள்ளிகள் பின்தங்கியிருந்தார் [1]. AlexNet போட்டியையே ஆதிக்கம் செலுத்தியது; அதை அது, பெரும்பாலானோர் நடைமுறைக்கு உதவாது என்று ஒதுக்கிய ஆழமான அடுக்குகளைக் கொண்ட Convolutional Neural Network (CNN) மூலமே செய்தது.
Convolutional Neural Networks
CNN என்பது convolutional layers ஐப் பயன்படுத்தும் ஒரு neural network model கட்டமைப்பு. படத் தரவுகளில் இவற்றின் உயர் செயல்திறனுக்காகவும், குறைந்த preprocessing அல்லது கைமுறை feature extraction தேவைக்காகவும் இந்த model கள் இன்று அறியப்படுகின்றன.
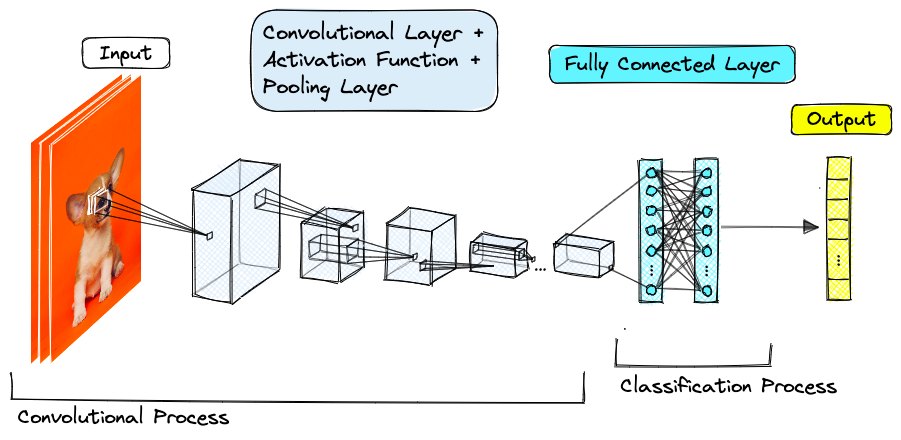
CNN கள் பல convolutional layers ஐ ஒன்றின் மேல் ஒன்றாக அடுக்கிப் பயன்படுத்துகின்றன. முதல் layers விளிம்புகள், வடிவங்கள், அமைப்புகள் (textures) போன்ற எளிய அம்சங்களை அடையாளம் காணும். network ஆழமாகச் செல்லச் செல்ல, அது மேலும் “abstract” ஆன வெளிப்பாடுகளை உருவாக்கி, இறுதியில் பாலூட்டிகள் முதல் நாய்கள் வரையும், ஏன் Siberian husky வரையும் கூடக் கருத்துக்களை அடையாளம் காணும்.
Convolutional Neural Networks பற்றி Embedding Methods for Image Search இன் அடுத்த அத்தியாயத்தில் இன்னும் விரிவாக விளக்கப்படும்.
இந்த networks பொதுவாக பல layers உம் பெருமளவு தரவும் இருக்கும்போதே சிறப்பாக வேலை செய்யும்; அதனால் அவை கவனிக்கப்படாமல் விடப்பட்டன. ஆழம் குறைந்த செயலாக்கங்கள் மற்ற networks ஐ விடப் பயன் எதுவும் தரவில்லை; ஆழமான செயலாக்கங்கள் கணிப்பீட்டு ரீதியில் நடைமுறைக்கு ஒவ்வாதவை; இந்த networks க்கு நிலைமை முழுவதும் எதிராகவே இருந்தது.
இந்தச் சாத்தியமான சவால்கள் இருந்தபோதிலும், இத்தகைய model ஒன்றைக் கொண்டு AlexNet இன் ஆசிரியர்கள் ILSVRC ஐ 9.8 சதவீதப் புள்ளிகள் வித்தியாசத்தில் வென்றனர். சரியான நேரத்தில், சரியான இடத்தில் இருந்த சரியான ஆட்கள் அவர்களே என்பது பின்னர் தெரியவந்தது.
இது வேலை செய்ய பல விசயங்கள் ஒன்று சேர்ந்தன. ஆழமான CNN ஐப் பயிற்றுவிக்கத் தேவையான பெருமளவு தரவை ImageNet வழங்கியது. சில ஆண்டுகளுக்கு முன்னர் Nvidia ஆனது, அதிக அளவில் இணையாகச் செயல்படும் GPU செயலாக்கத்தை மென்பொருள் அணுக உதவும் API ஆன CUDA ஐ வெளியிட்டிருந்தது [12][13]. பல GPU களைப் பயன்படுத்தி AlexNet இன் 60 மில்லியன் parameters ஐப் பயிற்றுவிப்பது நடைமுறைச் சாத்தியமாகும் அளவுக்கு GPU ஆற்றல் வளர்ந்திருந்தது.
AlexNet
AlexNet ஒன்றும் சிறியதல்ல. அதை வேலை செய்ய வைக்க, ஆசிரியர்கள் பல பிரச்சினைகளுக்குத் தீர்வு காண வேண்டியிருந்தது. அந்த model எட்டு layers ஐக் கொண்டிருந்தது: ஐந்து convolutional layers, அதைத் தொடர்ந்து மூன்று fully-connected linear layers. ImageNet க்குத் தேவையான 1000-label வகைப்படுத்தலை உருவாக்க, இறுதி layer 1000-node softmax ஐப் பயன்படுத்தி, 1000 வகுப்புகள் மீதான நிகழ்தகவுப் பரம்பலை உருவாக்கியது.
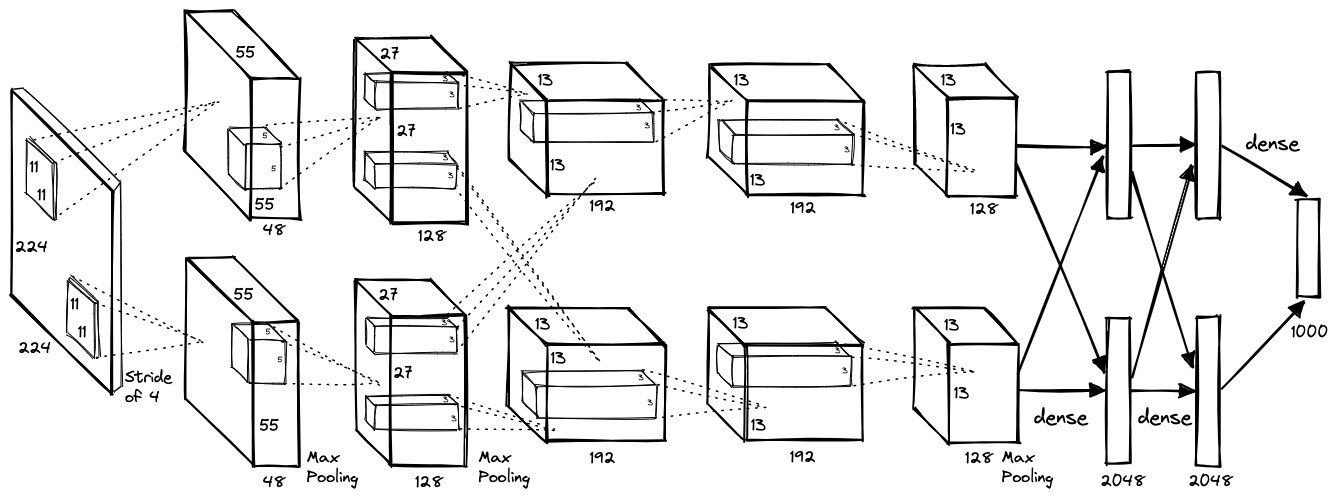
AlexNet இன் செயல்திறனுக்கு network இன் ஆழமே முக்கிய காரணம் என்பது AlexNet இலிருந்து கிடைத்த ஒரு முக்கிய முடிவு. அந்த ஆழம் ஏராளமான parameters ஐ உருவாக்கியதால், CPU இல் பயிற்றுவித்தால் பயிற்சி நடைமுறைக்கு ஒவ்வாத அளவு மெதுவாகும் அல்லது சாத்தியமே இல்லாமல் போகும். GPU இல் பயிற்றுவிப்பதன் மூலம் பயிற்சி நேரத்தை நடைமுறைக்கு ஏற்றதாக்க முடிந்தது. இருந்தாலும், அக்காலத்தின் உயர்தர GPU கள் ~3GB நினைவகத்துக்கு மட்டுப்படுத்தப்பட்டிருந்தன; AlexNet ஐப் பயிற்றுவிக்க அது போதாது.
இதை வேலை செய்ய வைக்க, AlexNet இரண்டு GPU களில் பகிரப்பட்டது. ஒவ்வொரு GPU உம் AlexNet இன் பாதிப் பகுதியைக் கையாண்டது. இரண்டு தனித்தனி model களைப் பயிற்றுவிக்கவில்லை என்பதை உறுதிப்படுத்த, அந்த இரு பாதிகளும் குறிப்பிட்ட layers இல் தொடர்பு கொண்டன.
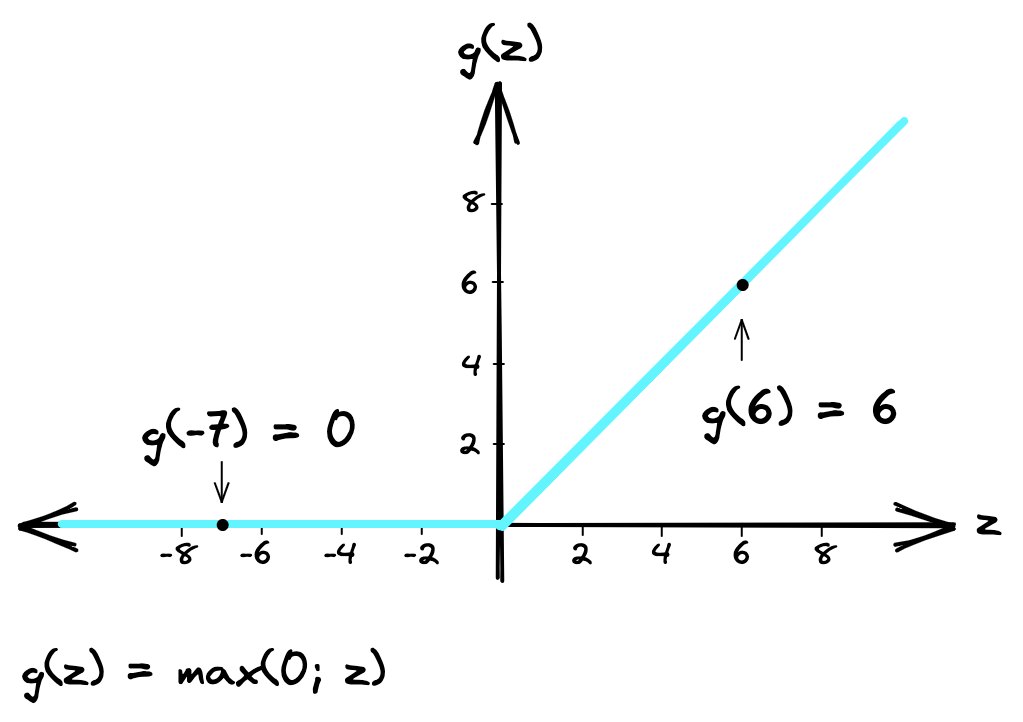
அக்காலத்தின் வழக்கமான sigmoid அல்லது tanh activation functions க்குப் பதிலாக Rectified Linear Unit (ReLU) activation functions ஐப் பயன்படுத்தியதன் மூலம் பயிற்சி நேரம் மேலும் குறைக்கப்பட்டது.
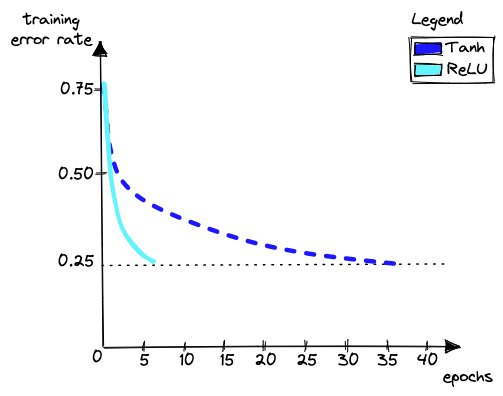
ReLU ஒரு எளிமையான செயற்பாடு; activations குறைந்தபட்ச/அதிகபட்ச மதிப்புகளை நோக்கிக் குவிவதை (saturation) தவிர்க்க மற்ற functions க்குத் தேவைப்படும் normalization இதற்குத் தேவையில்லை. அப்படி இருந்தும், Local Response Normalization (LRN) என்ற வேறு வகை normalization உம் சேர்க்கப்பட்டது. LRN ஐச் சேர்த்ததால் top-1, top-5 error rates முறையே 1.4% உம் 1.2% உம் குறைந்தன [1].
AlexNet இன் இன்னொரு முக்கிய கூறு overlapping pooling ஐப் பயன்படுத்தியது. ஒரு layer இல் உள்ள activations குழுவை, அடுத்த layer இல் ஒரே activation ஆகச் சுருக்குவதற்கு CNN கள் ஏற்கனவே pooling ஐப் பயன்படுத்தி வந்தன.
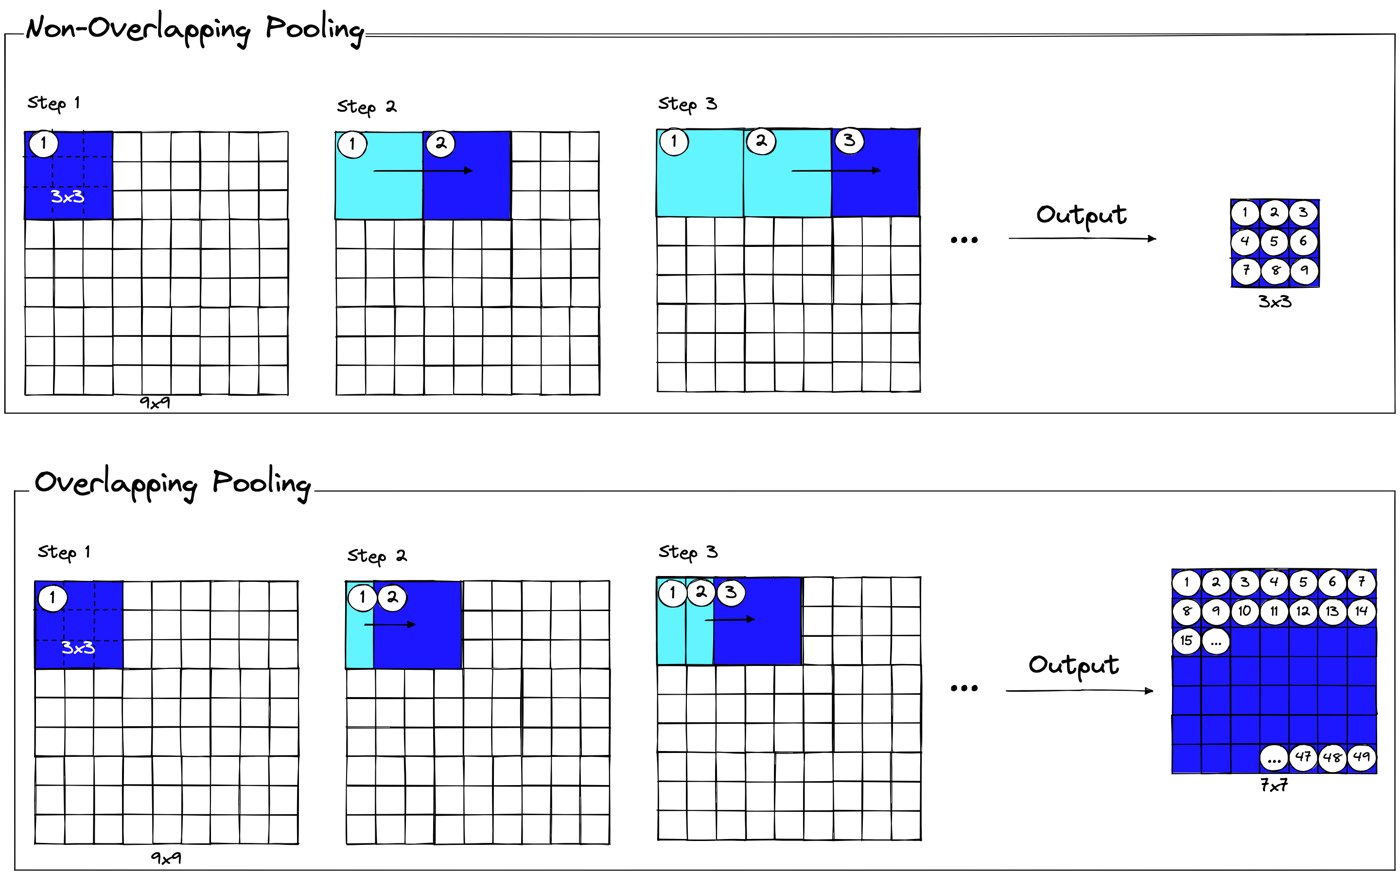
Overlapping pooling அதே செயற்பாட்டையே செய்கிறது; ஆனால் pooling window முந்தைய layer இன் மீது நகரும்போது, அது முந்தைய window உடன் மேலொட்டாகிறது. இது top-1, top-5 error rates ஐ முறையே 0.4% உம் 0.3% உம் மேம்படுத்துவதாகவும், overfitting ஐக் குறைப்பதாகவும் AlexNet கண்டறிந்தது.
AlexNet செயலில்
இவை எல்லாவற்றையும் பற்றிப் பேசுவது நல்லதுதான்; ஆனால் code இல் செயல்படுத்திப் பார்ப்பது அதைவிட நல்லது. கூடவே பின்தொடர விரும்பினால் Colab notebook ஐ இங்கே, TK, காணலாம்.
Data Preprocessing
முதலில் எமது தரவுத்தொகுதியைப் பதிவிறக்கம் செய்து preprocess செய்வோம். HuggingFace இல் வழங்கப்படும் ImageNet இன் ஒரு சிறிய மாதிரியை நாம் பயன்படுத்துவோம்.
# HuggingFace இலிருந்து தரவுத்தொகுதியை இறக்குமதி செய்தல்
from datasets import load_dataset

imagenet = load_dataset(
    'Maysee/tiny-imagenet',
    split='valid',
    ignore_verifications=True  # splits Error வந்தால் இதை True ஆக அமைக்கவும்
)
imagenet
Dataset({
features: ['image', 'label'],
num_rows: 10000
})imagenet[0] # ஒரு பதிவு{'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=64x64 at 0x105A9FA30>,
'label': 0}# படத்தின் வகையைச் சரிபார்த்தல்
type(imagenet[0]['image'])PIL.JpegImagePlugin.JpegImageFile# PIL படங்களை இப்படிப் பார்க்கலாம் (notebooks இல்):
imagenet[0]['image']<PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=64x64 at 0x165C59E20>Maysee/tiny-imagenet தரவுத்தொகுதி, train மற்றும் validation தொகுதிகளில் முறையே 100K, 10K லேபிள் இடப்பட்ட படங்களைக் கொண்டுள்ளது. எல்லாப் படங்களும் Python PIL objects ஆகச் சேமிக்கப்பட்டுள்ளன. இந்தப் படங்களின் preprocessing பல படிகளைக் கொண்டது:
- எல்லாப் படங்களையும் RGB வடிவத்துக்கு மாற்றுதல்.
- AlexNet எதிர்பார்க்கும் உள்ளீட்டுப் பரிமாணங்களுக்கு ஏற்ப அளவை மாற்றுதல்.
- tensor வடிவத்துக்கு மாற்றுதல்.
- மதிப்புகளை normalize செய்தல்.
- இந்த tensors தொகுதியை ஒரே batch ஆக அடுக்குதல்.
நாம் RGB இலிருந்து தொடங்குகிறோம்; எல்லாப் படங்களுக்கும் மூன்று நிறச் சேனல்கள் (Red, Green, Blue) இருக்கும் என AlexNet எடுத்துக்கொள்கிறது. ஆனால் L (grayscale), RGBA, CMYK போன்ற வேறு பல வடிவங்களையும் PIL ஆதரிக்கிறது. RGB அல்லாத எல்லா PIL objects ஐயும் RGB வடிவத்துக்கு மாற்ற வேண்டும்.
# RGB என்பதைச் சரிபார்த்தல்; இந்தப் படம் சரியாக உள்ளது
imagenet[0]['image'].mode'RGB'# 'L' என்பது grayscale; அதை RGB ஆக மாற்ற வேண்டும்
imagenet[201]['image'].mode'L'imagenet[201]['image'] # இது grayscale என்பதைக் காணலாம்<PIL.JpegImagePlugin.JpegImageFile image mode=L size=64x64 at 0x15F634D30>img = imagenet[201]['image'].convert('RGB')
img # இன்னும் grayscale ஆகவே காட்டப்படும்<PIL.Image.Image image mode=RGB size=64x64 at 0x15F634D60>AlexNet உம், முன்கூட்டியே பயிற்றுவிக்கப்பட்ட (pretrained) பல model களும், உள்ளீட்டுப் படங்கள் (3 x H x W) பரிமாணங்கள் கொண்ட tensors ஆக இருக்கும் என எதிர்பார்க்கின்றன; இங்கே 3 என்பது மூன்று நிறச் சேனல்களைக் குறிக்கிறது. H உம் W உம் குறைந்தது 224 பரிமாணம் கொண்டிருக்க வேண்டும் என எதிர்பார்க்கப்படுகிறது [14]. நாம் எமது படங்களின் அளவை மாற்ற வேண்டும்; இதை torchvision.transforms ஐப் பயன்படுத்தி இலகுவாகச் செய்யலாம்.
from torchvision import transforms

# அளவை மாற்றி 224x224 ஆக வெட்டுதல்
preprocess = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224)
])

new_img = preprocess(imagenet[0]['image'])
new_img
<PIL.Image.Image image mode=RGB size=224x224 at 0x176F5F130>இறுதியாக, PyTorch docs இல் உள்ள செயலாக்கக் குறிப்புகளின்படி [14], mean = [0.485, 0.456, 0.406], std = [0.229, 0.224, 0.225] ஐப் பயன்படுத்தி image tensors ஐ [0, 1] வீச்சுக்கு normalize செய்ய வேண்டும்.
# அளவை மாற்றி 224x224 ஆக வெட்டுதல்
preprocess = transforms.Compose([
    transforms.ToTensor(),  # பிழையைத் தவிர்க்க norm க்கு முன் PIL image ஐ tensor ஆக மாற்றுதல்
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])

# இறுதி முடிவு (3, 224, 224) வடிவம் கொண்ட normalize செய்யப்பட்ட tensor
new_img = preprocess(new_img)
இவை எல்லாவற்றையும் 50 படங்கள் கொண்ட ஒரு batch ஆக இணைக்கலாம். முழுத் தரவுத்தொகுதி மீதும் preprocessing ஐ ஓட்டி எல்லாவற்றையும் நினைவகத்தில் வைத்திருக்காமல், batch batch ஆகவே செயலாக்க வேண்டும். இந்த எடுத்துக்காட்டில், முதல் 50 படங்களை மட்டுமே சோதிப்போம்; ஏனெனில் இவை எல்லாவற்றுக்கும் “goldfish” என்றே லேபிள் இடப்பட வேண்டும் என்பது எமக்குத் தெரியும்.
from tqdm.auto import tqdm
import torch

# preprocessing pipeline ஐ வரையறுத்தல்
preprocess = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

inputs = []

for image in tqdm(imagenet[:50]['image']):
    # grayscale இலிருந்து RBG க்கு மாற்றுதல்
    if image.mode != 'RGB':
        image = image.convert("RGB")
    # preprocessing
    input_tensor = preprocess(image)
    inputs.append(input_tensor)

# batch பட்டியலை tensor ஆக மாற்றுதல் (model எதிர்பார்ப்பது போல)
inputs = torch.stack(inputs)
inputs.size()
0%| | 0/50 [00:00<?, ?it/s]torch.Size([50, 3, 224, 224])எமது முதல் batch ஐ நாம் preprocess செய்து முடித்துவிட்டோம்; (3, 224, 244) வடிவம் கொண்ட 50 உள்ளீட்டு tensors அடங்கிய tensors ஐ உருவாக்கியுள்ளோம்; இவை AlexNet உடன் inference க்குத் தயாராக உள்ளன.
Inference
AlexNet உடன் inference செய்ய (அதாவது கணிப்புகளைச் செய்ய), முதலில் நாம் model ஐப் பதிவிறக்க வேண்டும். PyTorch வழங்கும் pretrained AlexNet ஐ நாம் பதிவிறக்குவோம்.
import torch

# pytorch hub இலிருந்து pretrained alexnet ஐ ஏற்றுதல்
model = torch.hub.load('pytorch/vision:v0.10.0', 'alexnet', pretrained=True)
model.eval()  # model ஐ evaluation mode க்கு அமைத்தல் (inference க்காக)
AlexNet(
(features): Sequential(
(0): Conv2d(3, 64, kernel_size=(11, 11), stride=(4, 4), padding=(2, 2))
(1): ReLU(inplace=True)
(2): MaxPool2d(kernel_size=3, stride=2, padding=0, dilation=1, ceil_mode=False)
(3): Conv2d(64, 192, kernel_size=(5, 5), stride=(1, 1), padding=(2, 2))
(4): ReLU(inplace=True)
(5): MaxPool2d(kernel_size=3, stride=2, padding=0, dilation=1, ceil_mode=False)
(6): Conv2d(192, 384, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(7): ReLU(inplace=True)
(8): Conv2d(384, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(9): ReLU(inplace=True)
(10): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(11): ReLU(inplace=True)
(12): MaxPool2d(kernel_size=3, stride=2, padding=0, dilation=1, ceil_mode=False)
)
(avgpool): AdaptiveAvgPool2d(output_size=(6, 6))
(classifier): Sequential(
(0): Dropout(p=0.5, inplace=False)
(1): Linear(in_features=9216, out_features=4096, bias=True)
(2): ReLU(inplace=True)
(3): Dropout(p=0.5, inplace=False)
(4): Linear(in_features=4096, out_features=4096, bias=True)
(5): ReLU(inplace=True)
(6): Linear(in_features=4096, out_features=1000, bias=True)
)
)இங்கே AlexNet இன் network கட்டமைப்பைக் காணலாம்: ஐந்து convolutional layers, அதைத் தொடர்ந்து மூன்று feed-forward linear layers. இது அசல் AlexNet இன் மிகவும் திறன்மிக்க ஒரு மாற்றமாகும்; இதை Krizhevsky பின்னர் வெளியிட்ட ஒரு ஆய்வுக் கட்டுரையில் [15] முன்மொழிந்தார்.
இயல்பாக model CPU இல் ஏற்றப்படுகிறது. இங்கேயே அதை ஓட்டலாம்; ஆனால் CUDA வசதியுள்ள GPU இல் அல்லது Apple Silicon இல் MPS இல் ஓட்டுவது இன்னும் திறன்மிக்கது. இதை device ஐ இப்படி அமைப்பதன் மூலம் செய்கிறோம்:
# device கிடைக்குமாயின் அதற்கு நகர்த்துதல்
device = torch.device(
    'cuda' if torch.cuda.is_available() else (
        'mps' if torch.backends.mps.is_available() else 'cpu'
    )
)
இதிலிருந்து, inference செய்வதற்கு முன் உள்ளீட்டு tensors ஐயும் model ஐயும் எப்போதும் device க்கு நகர்த்த வேண்டும். நகர்த்தியதும், model(inputs) மூலம் inference ஐ ஓட்டுகிறோம்.
# உள்ளீடுகளையும் model ஐயும் device க்கு நகர்த்துதல்
inputs = inputs.to(device)
model.to(device)

# model ஐ ஓட்டுதல்
with torch.no_grad():
    output = model(inputs).detach()
print(output.shape)
output
torch.Size([50, 1000])tensor([[ 7.2008, 14.0141, -0.4883, ..., 5.5724, 1.0935, -5.2350],
[ 3.2615, 9.6214, 1.8129, ..., -1.4830, 0.0919, -1.8151],
[ 6.8251, 15.3777, 1.0032, ..., 2.2704, 0.9593, -3.7721],
...,
[ 3.5202, 10.5097, -3.0180, ..., 2.2333, 0.5606, -2.0211],
[ 3.6958, 13.0405, 0.9107, ..., -1.4827, 2.8325, -5.1292],
[ 3.4574, 8.3314, -2.0551, ..., 1.7834, 1.5504, -3.1021]],
device='mps:0')# கணிப்பு
preds = torch.argmax(output, dim=1).cpu().numpy()
print(preds.shape)
preds(50,)array([ 1, 1, 1, 1, 392, 1, 392, 1, 392, 1, 1, 1, 782,
1, 392, 73, 392, 1, 29, 750, 392, 73, 738, 1, 1, 1,
1, 491, 1, 1, 1, 98, 1, 1, 1, 1, 1, 1, 1,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1])ஒவ்வொரு சாத்தியமான வகுப்புக்கும் model ஒரு logits (output activations) தொகுதியை வெளியிடும். model க்குள் நாம் செலுத்தும் ஒவ்வொரு படத்துக்கும் இப்படி 1000 உள்ளன. அதிகூடிய activation, ஒவ்வொரு படத்துக்கும் model கணிக்கும் வகுப்பைக் குறிக்கிறது. argmax function மூலம் இந்த logits ஐ வகுப்புக் கணிப்புகளாக மாற்றுகிறோம்.
கணிக்கப்பட்ட மதிப்புகளில் பெரும்பாலானவை வகுப்பு 1 க்குரியவை. அது எமக்கு எந்த அர்த்தமும் தராது; ஆகவே அதை PyTorch AlexNet வகுப்புகளுடன் இப்படி ஒப்பிட்டுச் சரிபார்க்கிறோம்:
import requests

res = requests.get("https://raw.githubusercontent.com/pytorch/hub/master/imagenet_classes.txt")
pred_labels = res.text.split('\n')
print(f"{len(pred_labels)}\n{pred_labels[1]}")1000
goldfishAlexNet model தெளிவாக goldfish ஐச் சரியாகவே கணிக்கிறது. துல்லியத்தை (accuracy) இப்படிக் கணக்கிடலாம்:
sum(preds == 1) / len(preds)இது goldfish வகுப்புக்கு 72% துல்லியத்தைத் தருகிறது. 28% top-1 error rate, அசல் AlexNet ஆய்வுக் கட்டுரையில் குறிப்பிடப்பட்ட சராசரி error rate ஆன 37.5% ஐ விடச் சிறந்தது. ஆனாலும் இது ஒரே ஒரு வகுப்புக்கு மட்டுமே; model இன் செயல்திறன் வகுப்புக்கு வகுப்பு மாறுபடும்.
computer vision, machine learning ஆகியவற்றில் நடந்த மிக முக்கியமான நிகழ்வுகளில் ஒன்றைப் பற்றிய எமது மேலோட்டம் இதுவே. ImageNet Challenge 2017 வரை ஆண்டுதோறும் நடத்தப்பட்டது. அதற்குள் 38 போட்டியாளர்களில் 29 பேர் 5% க்கும் குறைவான error rate ஐக் கொண்டிருந்தனர் [16]; இது ImageNet இன் செயற்பாட்டுக் காலத்தில் computer vision இல் ஏற்பட்ட மிகப் பெரிய முன்னேற்றத்தைக் காட்டுகிறது.
AlexNet ஐ இன்னும் ஆற்றல் வாய்ந்த CNN கள் பின்தள்ளிவிட்டன. 2015 இல் ILSVRC வெற்றியாளராக AlexNet ஐ Microsoft Research Asia பதவியிறக்கியது [17]. அதன் பின் பல CNN கட்டமைப்புகள் வந்து போயின. அண்மையில், transformer எனப்படும் இன்னொரு network கட்டமைப்பு computer vision இல் CNN களின் ஆதிக்கத்தைக் குலைக்கத் தொடங்கியுள்ளது.
AlexNet ஆய்வுக் கட்டுரையின் இறுதிப் பந்தி, AI இன் எதிர்காலத்துக்கும் computer vision க்கும் கிட்டத்தட்ட தீர்க்கதரிசனமாகவே அமைந்தது. அவர்கள் குறிப்பிட்டது:
“எமது பயிற்சிக்கு unsupervised pre-training ஐ நாம் பயன்படுத்தவில்லை; அது உதவும் என எதிர்பார்த்தாலும்”, மேலும் “எமது network ஐப் பெரிதாக்க எமது முடிவுகள் மேம்பட்டுள்ளன... மனிதப் பார்வை அமைப்பின் infero-temporal பாதையுடன் ஒப்பிடுமளவுக்கு நாம் இன்னும் பல பருமை வரிசைகள் (orders of magnitude) போக வேண்டியுள்ளது”
Unsupervised pre-training உம் இன்னும் பெரிய model களும் பிற்காலத்தில் மேலும் சிறந்த model களின் அடையாளமாக மாறின.
மூலங்கள் (Resources)
[1] A. Krizhevsky, I. Sutskever, G. Hinton, ImageNet Classification with Deep Convolutional Neural Networks (2012), NeurIPS
[2] ImageNet Large Scale Visual Recognition Challenge (ILSVRC) , ImageNet
[3] J. Dean, Machine Learning for Systems and Systems for Machine Learning (2017), NeurIPS 2017
[4] F. Li, Visual Recognition: Computational Models and Human Psychophysics (2005), Caltech
[5] G. Miller, R. Beckwith, C. Felbaum, D. Gross, K. Miller, Introduction to WordNet: An On-line Lexical Database (1993)
[6] D. Gershgorn, The data that transformed AI research — and possibly the world (2017), Quartz
[7] J. Deng, W. Dong, R. Socher, L. Li, K. Li, L. Fei-Fei, ImageNet: A large-scale hierarchical image database (2009), CVPR
[8] L. Ahn, L. Dabbish, Labeling images with a computer game (2004), Proc. SIGCHI
[9] I. Weber, S. Robertson, M. Vojnovic, Rethinking the ESP Game (2009), ACM
[10] A. Saini, Solving the web’s image problem (2008), BBC News
[11] O. Russakovsky, J. Deng, et. al., ImageNet Large Scale Visual Recognition Challenge (2015), IJCV
[12] F. Abi-Chahla, Nvidia’s CUDA: The End of the CPU? (2008), Tom’s Hardware
[13] A. Krizhevsky, cuda-convnet (2011), Google Code Archive
[14] AlexNet Implementation in PyTorch , PyTorch Resources
[15] A. Krizhevsky, One weird trick for parallelizing convolutional neural networks (2014)
[16] ILSVRC2017 Results (2017)
[17] K. He, X. Zhang, S. Ren, J. Sun, Deep Residual Learning for Image Recognition (2015)
இந்தக் கட்டுரை பயனுள்ளதாக இருந்ததா?
Source: https://www.pinecone.io/learn/series/image-search/imagenet/