Convolutional Neural Networks (CNN): அடிப்படை முதல் Deployment வரை ஒரு முழுமையான வழிகாட்டி
Convolutional neural network என்றால் என்ன?
Convolutional neural network (CNN) என்பது படங்கள், video, இடஞ்சார்ந்த சமிக்ஞைகள் போன்ற கட்டமைக்கப்பட்ட, வலை போன்ற தரவைச் செயலாக்குவதற்காகவே வடிவமைக்கப்பட்ட deep learning கட்டமைப்பு.
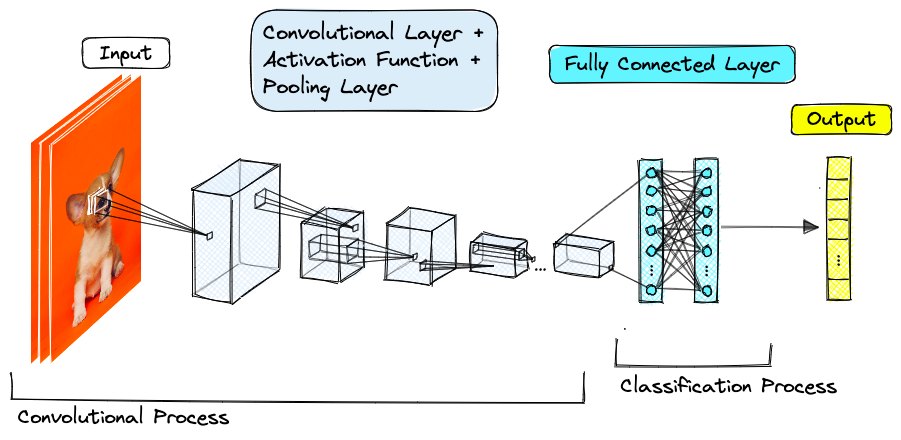
அடிப்படைக் கட்டமைப்பும் layers உம்
- Convolutional layer: கற்கக்கூடிய filters (kernels) உள்ளீட்டின் மீது நகர்ந்து, element-wise பெருக்கல்கள் மூலம் விளிம்புகள், அமைப்புகள், வடிவங்கள் போன்ற உள்ளூர் இடஞ்சார்ந்த அம்சங்களைப் பிரித்தெடுக்கும்.
- Activation layer (ReLU): எதிர்மறை மதிப்புகளைப் பூச்சியமாக்கி, நேர்மறை மதிப்புகளை மாற்றாமல் வைத்து non-linearity ஐச் சேர்க்கும்; அதனால் network சிக்கலான வடிவங்களைக் கற்க முடிகிறது.
- Pooling layer: feature map ஐச் சிறிதாக்கும் (பொதுவாக max pooling மூலம்); இடஞ்சார்ந்த பரிமாணங்களைக் குறைத்து, கணிப்பீட்டைக் குறைத்து, translation invariance ஐ உருவாக்கும்.
- Flatten layer: பல்பரிமாண feature maps ஐ 1D vector ஆக மாற்றும்; அதனால் அவை பாரம்பரிய layers க்குள் செல்ல முடிகிறது.
- Fully connected (dense) layer: பிரித்தெடுத்த அம்சங்களை இணைத்து உயர்நிலைத் தர்க்கம் செய்து, softmax function மூலம் இறுதி வகைப்படுத்தல் நிகழ்தகவுகளை வெளியிடும்.
முக்கிய வடிவமைப்புக் கொள்கைகள்
- Parameter sharing: ஒரே kernel weights உள்ளீட்டின் வெவ்வேறு இடங்களில் மீண்டும் பயன்படுத்தப்படுவதால், சாதாரண neural network உடன் ஒப்பிடும்போது பயிற்றுவிக்கக்கூடிய parameters இன் எண்ணிக்கை பெருமளவு குறைகிறது.
- Local connectivity: ஒவ்வொரு neuron உம் ஒரு சிறிய உள்ளூர்ப் பகுதியை, அதாவது தன் receptive field ஐ, மட்டுமே செயலாக்குவதால் நெருங்கிய இடஞ்சார்ந்த தொடர்புகளைப் பிடிக்கிறது.
- Hierarchical learning: ஆரம்ப layers விளிம்புகள், நிறச் சரிவுகள் போன்ற தாழ்நிலை விவரங்களைக் கண்டறிகின்றன; ஆழமான layers அவற்றை முகங்கள், எழுத்து, மருத்துவ அசாதாரணங்கள் போன்ற சிக்கலான பொருட்களாக இணைக்கின்றன.
CNN Explainer என்ற ஊடாடும் கருவி, இந்த layers வழியாகத் தரவு எப்படிப் பாய்கிறது என்பதைக் காட்சியாக விளக்குகிறது. ஒரு CNN எப்படிக் கட்டப்படுகிறது என்பது உங்கள் தரவு வகையையும் நீங்கள் விரும்பும் coding framework ஐயும் பெரிதும் சார்ந்தது; அதனால் அடுத்த இரு பகுதிகளும் இரண்டையும் விளக்குகின்றன.
பயன்பாடுகள்: உங்கள் தரவு network ஐ எப்படி வடிவமைக்கிறது
நிஜ உலகப் பிரச்சினைகள் வெவ்வேறாக இருப்பதால், அவற்றுக்கு வெவ்வேறு convolution பரிமாணங்களும் வெளியீட்டு layers உம் தேவை.
- Image classification: நிறச் சேனல்கள் முழுவதும் உயரத்தையும் அகலத்தையும் வருடும் 2D convolutions (Conv2D) ஐப் பயன்படுத்தி, ஒரு முழுப் படத்துக்கு ஒரே label ஐ, உதாரணமாக பூனை அல்லது நாய் என்பதை, வழங்குகிறது.
- Medical imaging: MRI, CT போன்ற கனஅளவு scans க்கு பெரும்பாலும் 3D convolutions (Conv3D) ஐயும், கட்டிகள் அல்லது உறுப்புகளின் சரியான pixel எல்லைகளை வரையும் U-Net போன்ற சிறப்பு encoder-decoder கட்டமைப்புகளையும் பயன்படுத்துகிறது.
- Time-series, audio தரவு: பங்கு விலைகள், sensor அளவீடுகள், ஒலி அலைவடிவங்களில் உள்ளூர்ப் போக்குகளைக் கண்டறிய, ஒரே நேர அச்சில் நகரும் 1D convolutions (Conv1D) ஐப் பயன்படுத்துகிறது.
Framework தெரிவு: PyTorch அல்லது TensorFlow
இரண்டு frameworks உம் தொழில்துறைத் தரநிலைகள்; ஆனால் code எழுதத் தொடங்கும்போது அவை வெவ்வேறு வேலைப்பாய்வுகளைத் தருகின்றன.
| அம்சம் | PyTorch | TensorFlow (Keras உடன்) |
|---|---|---|
| Coding பாணி | Pythonic, object-oriented; பயிற்சி loop மீது வரிக்கு வரி வெளிப்படையான கட்டுப்பாடு தருகிறது. | உயர்நிலை, declarative; குறைந்த boilerplate code உடன் layers ஐ விரைவாக அடுக்க உதவுகிறது. |
| எதற்குச் சிறந்தது | கல்வி ஆய்வு, தனிப்பயன் layer கட்டமைப்புகள், உள்ளுணர்வுக்கு இசைவான படிப்படியான debugging. | விரைவான prototyping, நிறுவன உற்பத்தி pipelines, மொபைல் அல்லது edge deployment (TFLite). |
| அடிப்படை CNN syntax | torch.nn.Conv2d(...) | tf.keras.layers.Conv2D(...) |
அடிப்படை CNN: PyTorch இலும் TensorFlow இலும்
1. PyTorch இல் அடிப்படை CNN
PyTorch, object-oriented அணுகுமுறையைப் பயன்படுத்துகிறது: உங்கள் layers ஐ __init__ இனுள் வரையறுத்து, தரவு அவற்றினூடாக எப்படிப் பாய்கிறது என்பதை forward இல் விவரிக்கிறீர்கள்.
import torch
import torch.nn as nn
import torch.nn.functional as F

class BasicCNN(nn.Module):
    def __init__(self, num_classes=10):
        super(BasicCNN, self).__init__()
        # Input: 3 color channels (RGB), Output: 16 feature maps, 3x3 kernel
        self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
        self.conv2 = nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1)
        # Assuming input image is 32x32, after two 2x2 pools it becomes 8x8
        self.fc1 = nn.Linear(32 * 8 * 8, 128)
        self.fc2 = nn.Linear(128, num_classes)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))  # Output: [batch, 16, 16, 16]
        x = self.pool(F.relu(self.conv2(x)))  # Output: [batch, 32, 8, 8]
        x = x.view(-1, 32 * 8 * 8)            # Flatten into 1D vector
        x = F.relu(self.fc1(x))
        x = self.fc2(x)                       # Raw logits (Softmax applied in loss)
        return x

# Example usage with a dummy batch of 4 RGB images (32x32)
model = BasicCNN(num_classes=10)
dummy_input = torch.randn(4, 3, 32, 32)
output = model(dummy_input)
print("PyTorch Output Shape:", output.shape)  # Expected: [4, 10]
2. TensorFlow (Keras) இல் அடிப்படை CNN
TensorFlow இன் Keras API, குறைந்த boilerplate உடன் layers ஐ வரிசையாக அடுக்க உதவுகிறது; layers இடையிலான உள்ளீட்டு வடிவங்களையும் தானாகவே ஊகிக்கிறது.
import tensorflow as tf
from tensorflow.keras import layers, models

def build_basic_cnn(input_shape=(32, 32, 3), num_classes=10):
    model = models.Sequential([
        # First Convolutional Block
        layers.Conv2D(16, (3, 3), padding='same', activation='relu', input_shape=input_shape),
        layers.MaxPooling2D((2, 2)),
        # Second Convolutional Block
        layers.Conv2D(32, (3, 3), padding='same', activation='relu'),
        layers.MaxPooling2D((2, 2)),
        # Classification Head
        layers.Flatten(),
        layers.Dense(128, activation='relu'),
        layers.Dense(num_classes, activation='softmax')
    ])
    return model

# Example usage
model = build_basic_cnn()
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy', metrics=['accuracy'])
model.summary()
சிறப்பு CNN கட்டமைப்புகள்: ResNet உம் U-Net உம்
அடிப்படை CNN கள் layers ஐ ஒன்றன்பின் ஒன்றாக அடுக்குகின்றன; ஆனால் சிக்கலான நிஜ உலகப் பணிகளுக்கு, பயிற்சித் தடைகளை வெல்லவும் இடஞ்சார் விவரங்களைப் பாதுகாக்கவும் சிறப்புக் கட்டமைப்பு வடிவங்கள் தேவை.
ResNet (Residual Network)
- முக்கிய புதுமை: ஒரு block இன் அசல் உள்ளீட்டை நேரடியாக அதன் வெளியீட்டுடன், F(x) + x ஆகக், கூட்டும் skip connections (residual blocks).
- தீர்க்கும் பிரச்சினை: 50, 101 அல்லது 152+ layers கொண்ட மிக ஆழமான networks இல், backpropagation இன்போது பிழைச் சமிக்ஞை பூச்சியமாகச் சுருங்குவதால் ஆரம்ப layers கற்பதை நிறுத்திவிடும் vanishing gradient பிரச்சினை.
- எதற்குச் சிறந்தது: ஆழமான image classification, object detection backbones, வளமான உயர்நிலைக் காட்சி அம்சங்கள் தேவைப்படும் transfer learning பணிகள்.
U-Net
- முக்கிய புதுமை: “U” எழுத்து வடிவிலான சமச்சீர் encoder-decoder; encoder இலிருந்து உயர்-தெளிவுத்திறன் feature maps ஐ நேரடியாக decoder க்கு நகலெடுக்கும், network முழுவதும் பரவிய skip connections இனால் இணைக்கப்பட்டது.
- தீர்க்கும் பிரச்சினை: சாதாரண CNN கள் pooling இன்போது சரியான pixel இடங்களை இழக்கின்றன. U-Net முழு இடஞ்சார்ந்த தெளிவுத்திறனை மீட்டெடுப்பதால், ஒரு பொருள் என்ன என்பதை மட்டுமல்ல, எங்கே இருக்கிறது என்பதையும் model அறிகிறது.
- எதற்குச் சிறந்தது: semantic segmentation (ஒரு படத்தின் ஒவ்வொரு pixel க்கும் label இடுதல்), கட்டிகள் அல்லது கலச் சுவர்களைக் கண்டறிவது போன்ற medical imaging, பட உருவாக்கத்துக்கான diffusion models.
பயிற்சி loops
neural network ஐப் பயிற்றுவிப்பது என்பது, தரவின் batches ஐ model வழியாகச் செலுத்தி, கணிப்புகள் எவ்வளவு தவறு (loss) என்று கணக்கிட்டு, அந்தப் பிழையைக் குறைக்க model இன் weights ஐப் புதுப்பிப்பது.
PyTorch பயிற்சி loop
PyTorch இல் forward pass ஐயும், gradients ஐப் பூச்சியமாக்குவதையும், backpropagation ஐயும், optimizer இன் படியையும் நீங்களே எழுத வேண்டும்.
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# 1. Create dummy dataset (100 RGB images of size 32x32, 10 classes)
X_train = torch.randn(100, 3, 32, 32)
y_train = torch.randint(0, 10, (100,))
train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=16, shuffle=True)

# 2. Initialize model, loss function, and optimizer (using BasicCNN from earlier)
model = BasicCNN(num_classes=10)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 3. Run the training loop
epochs = 5
model.train()  # Set model to training mode
for epoch in range(epochs):
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()              # Clear old gradients
        outputs = model(inputs)            # Forward pass
        loss = criterion(outputs, labels)  # Calculate loss
        loss.backward()                    # Backward pass (compute gradients)
        optimizer.step()                   # Update weights
        running_loss += loss.item()
    print(f"Epoch {epoch+1}/{epochs} - Loss: {running_loss/len(train_loader):.4f}")
TensorFlow (Keras) பயிற்சி loop
model ஐ compile செய்தபின், TensorFlow பயிற்சிப் படிகளை ஒரே .fit() method க்குள் அடக்குகிறது.
import numpy as np
import tensorflow as tf

# 1. Create dummy dataset (100 RGB images of size 32x32, 10 classes)
X_train = np.random.randn(100, 32, 32, 3).astype(np.float32)
y_train = np.random.randint(0, 10, size=(100,))

# 2. Build and compile the model (using build_basic_cnn from earlier)
model = build_basic_cnn(input_shape=(32, 32, 3), num_classes=10)
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=0.001),
    loss='sparse_categorical_crossentropy',
    metrics=['accuracy']
)

# 3. Train the model
history = model.fit(
    X_train, y_train,
    batch_size=16,
    epochs=5,
    validation_split=0.2  # Automatically hold out 20% for validation
)
Pretrained ResNet உடன் transfer learning
Transfer learning, ImageNet தரவுத்தொகுதி போன்ற மில்லியன் கணக்கான படங்களில் ஏற்கனவே பயிற்சி பெற்ற model ஐ எடுத்து, உங்கள் சொந்தத் தரவுத்தொகுதிக்கு ஏற்ப மாற்றுகிறது. ஆரம்ப convolutional layers ஐ freeze செய்வதால் அவை விளிம்பு, வடிவம் கண்டறியும் திறனை வைத்திருக்கும்; இறுதி classification layer ஐ மட்டும் மாற்றுகிறீர்கள்.
PyTorch இல் pretrained ResNet-50
torchvision.models மூலம் pretrained weights ஐ ஏற்றி, எல்லா parameters ஐயும் freeze செய்து, இறுதி fully connected layer ஐ (model.fc) மேலெழுதுகிறீர்கள்.
import torch.nn as nn
import torchvision.models as models

# 1. Load ResNet-50 with default ImageNet weights
weights = models.ResNet50_Weights.DEFAULT
model = models.resnet50(weights=weights)

# 2. Freeze all existing convolutional layers
for param in model.parameters():
    param.requires_grad = False

# 3. Replace the final classification head for your custom number of classes
num_custom_classes = 5
in_features = model.fc.in_features
model.fc = nn.Linear(in_features, num_custom_classes)

# Only model.fc parameters will be updated during training
optimizer = torch.optim.Adam(model.fc.parameters(), lr=0.001)
TensorFlow (Keras) இல் pretrained ResNet-50
tf.keras.applications மூலம் base model ஐ அதன் மேல் classification layer இன்றி (include_top=False) ஏற்றி, freeze செய்து, உங்கள் சொந்த pooling, dense layers ஐ இணைக்கிறீர்கள்.
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. Load ResNet-50 base without the original 1000-class ImageNet head
base_model = tf.keras.applications.ResNet50(
    weights='imagenet',
    include_top=False,
    input_shape=(224, 224, 3)
)

# 2. Freeze the base model weights
base_model.trainable = False

# 3. Attach a new classification head for your custom classes
num_custom_classes = 5
model = models.Sequential([
    base_model,
    layers.GlobalAveragePooling2D(),
    layers.Dense(128, activation='relu'),
    layers.Dense(num_custom_classes, activation='softmax')
])
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy', metrics=['accuracy'])
பயிற்சி பெற்ற CNN ஐ மதிப்பிடுதலும் debug செய்தலும்
துல்லியம் மட்டும் தீவிரமான பிரச்சினைகளை மறைக்கலாம்; உதாரணமாக அரிதான வகுப்புகளை model புறக்கணித்தல், அல்லது பொருளைப் பார்க்காமல் பின்னணிச் சுட்டிகளைப் பார்த்து ஏமாற்றுதல்.
Confusion matrices உம் வகைப்படுத்தல் அளவீடுகளும்
- அது என்ன செய்கிறது: confusion matrix, model கணித்த labels ஐ உண்மையான ground-truth labels உடன் ஒரு கட்டத்தில் ஒப்பிட்டு, ஒவ்வொரு வகுப்புக்கும் true positives, false positives, false negatives இன் சரியான எண்ணிக்கைகளைக் காட்டுகிறது.
- முக்கிய வழி அளவீடுகள்: precision, நேர்மறைக் கணிப்புகள் எவ்வளவு அடிக்கடி சரியாக இருக்கின்றன என்பதை அளக்கிறது; recall, உண்மையான நேர்மறைகளில் எத்தனையை model பிடித்தது என்பதை அளக்கிறது.
- விரைவான Python செயலாக்கம்: உங்கள் validation தொகுதியிலிருந்து கணிப்புகளைச் சேகரித்ததும், scikit-learn மூலம் matrix ஐ உருவாக்கலாம்.
from sklearn.metrics import confusion_matrix, classification_report
import numpy as np

# Example true labels and model predictions
y_true = np.array([0, 1, 2, 2, 0, 1])
y_pred = np.array([0, 2, 2, 2, 0, 1])

print("Confusion Matrix:\n", confusion_matrix(y_true, y_pred))
print("\nDetailed Report:\n", classification_report(y_true, y_pred))
Grad-CAM (Gradient-weighted Class Activation Mapping)
- அது என்ன செய்கிறது: Grad-CAM, உங்கள் உள்ளீட்டுப் படத்தின் மீது நிறக் குறியீடு கொண்ட heatmap ஐ உருவாக்கி, CNN இன் இறுதி முடிவுக்கு அதிகம் பங்களித்த சரியான pixels ஐ எடுத்துக்காட்டுகிறது.
- ஏன் முக்கியம்: இது “shortcut learning” ஐப் பிடிக்கிறது; உதாரணமாக ஒரு model படகை அடையாளம் காண, படகைப் பார்க்காமல் நீரைப் பார்க்கிறது என்பதைக் கண்டறிதல்.
- எப்படி வேலை செய்கிறது: இடஞ்சார்ந்த இடங்களை இன்னும் வைத்திருக்கும் இறுதி convolutional layer க்குள் பாயும் gradients ஐக் கண்காணித்து, இலக்கு வகுப்புக்கு ஒவ்வொரு feature map உம் எவ்வளவு முக்கியம் என்பதன்படி அதற்கு எடை வழங்குகிறது.
உண்மையான பட தரவுத்தொகுதிகளைத் தயார்செய்தலும் பெருக்குதலும்
raw படங்கள் அளவு, ஒளி, திசையமைவில் வேறுபடுவதால், அவை CNN க்குள் நுழையும் முன் தரப்படுத்தப்பட்டு செயற்கையாகப் பெருக்கப்பட வேண்டும்.
அவசியமான preprocessing படிகள்
- Resizing: எல்லாப் படங்களையும் 224×224 போன்ற நிலையான பரிமாணங்களுக்குத் தரப்படுத்துவதால், அவை ஒரே சீரான batches ஆக அடுக்கப்பட முடிகிறது.
- Normalization: pixel செறிவு மதிப்புகளை [0, 255] இலிருந்து [0, 1] ஆகக் குறைக்கிறது, அல்லது தரவுத்தொகுதியின் mean, standard deviation கொண்டு தரப்படுத்துகிறது; அதனால் gradients சீராகப் புதுப்பிக்கப்படுகின்றன.
- Dataset splitting: தரவை Training (70 முதல் 80%, weights ஐக் கற்க), Validation (10 முதல் 15%, hyperparameters ஐச் சரிசெய்ய), Test (10 முதல் 15%, இறுதி மதிப்பீட்டுக்கு மட்டும் கண்டிப்பாக ஒதுக்கி வைக்கப்படுவது) எனப் பிரிக்கிறது.
Data augmentation pipelines
Data augmentation, பயிற்சியின்போது சீரற்ற, நம்பத்தக்க மாற்றங்களை உடனுக்குடன் பயன்படுத்துவதால், model ஒரே படத்தை இருமுறை சரியாகப் பார்ப்பதே இல்லை; இது overfitting ஐக் குறைக்கிறது. PyTorch இல் (torchvision.transforms):
from torchvision import transforms

train_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.RandomRotation(degrees=15),
    transforms.ColorJitter(brightness=0.2, contrast=0.2),
    transforms.ToTensor(),  # Converts [0, 255] image to [0.0, 1.0] tensor
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])
TensorFlow இல் (tf.keras.layers):
import tensorflow as tf
from tensorflow.keras import layers

data_augmentation = tf.keras.Sequential([
    layers.Resizing(224, 224),
    layers.Rescaling(1./255),
    layers.RandomFlip("horizontal"),
    layers.RandomRotation(0.05),  # ~18 degrees
    layers.RandomContrast(0.2)
])
Grad-CAM code
Grad-CAM heatmap ஐ உருவாக்க, இறுதி convolutional layer இன் feature maps ஐயும், backpropagation இன்போது அந்த layer க்குள் திரும்பப் பாயும் gradients ஐயும் பிடிக்கிறீர்கள்.
PyTorch Grad-CAM (கைமுறை hooks)
Forward, backward hooks மூலம், உங்கள் model class ஐ மாற்றாமல் எந்த இலக்கு layer இலிருந்தும் activations ஐயும் gradients ஐயும் எடுக்கலாம். pytorch-grad-cam நூலகம் இன்னொரு தெரிவு.
import torch
import torch.nn.functional as F
import numpy as np
import cv2

def generate_gradcam_pytorch(model, input_tensor, target_layer, class_idx=None):
    model.eval()
    activations = []
    gradients = []

    # 1. Register hooks to capture forward activations and backward gradients
    def forward_hook(module, inp, out):
        activations.append(out)

    def backward_hook(module, grad_in, grad_out):
        gradients.append(grad_out[0])

    handle_f = target_layer.register_forward_hook(forward_hook)
    handle_b = target_layer.register_full_backward_hook(backward_hook)

    # 2. Forward pass and backward pass for the target class
    output = model(input_tensor)
    if class_idx is None:
        class_idx = output.argmax(dim=1).item()

    model.zero_grad()
    output[0, class_idx].backward()

    # 3. Compute importance weights via Global Average Pooling of gradients
    grads = gradients[0].detach()[0]
    acts = activations[0].detach()[0]
    weights = grads.mean(dim=(1, 2), keepdim=True)

    # 4. Weighted combination of feature maps + ReLU
    cam = F.relu((weights * acts).sum(dim=0)).cpu().numpy()
    cam = cv2.resize(cam, (input_tensor.shape[3], input_tensor.shape[2]))
    cam = (cam - cam.min()) / (cam.max() - cam.min() + 1e-8)  # Normalize 0 to 1

    # Clean up hooks
    handle_f.remove()
    handle_b.remove()
    return cam

# Usage example with ResNet-50:
# heatmap = generate_gradcam_pytorch(resnet_model, image_tensor, resnet_model.layer4[-1])
tf.GradientTape கொண்ட TensorFlow (Keras) Grad-CAM
TensorFlow இல், இறுதி convolutional layer ஐயும் இறுதிக் கணிப்புகளையும் வெளியிடும் ஒரு தற்காலிக sub-model ஐ உருவாக்கி, GradientTape க்குள் gradients ஐப் பதிவு செய்கிறீர்கள்.
import tensorflow as tf
import numpy as np
import cv2

def generate_gradcam_tf(model, img_array, last_conv_layer_name, class_idx=None):
    # 1. Build a model mapping input -> [last conv layer output, final predictions]
    grad_model = tf.keras.models.Model(
        inputs=model.inputs,
        outputs=[model.get_layer(last_conv_layer_name).output, model.output]
    )

    # 2. Record gradients of the predicted class with respect to the conv layer
    with tf.GradientTape() as tape:
        conv_outputs, predictions = grad_model(img_array)
        if class_idx is None:
            class_idx = tf.argmax(predictions[0])
        class_score = predictions[:, class_idx]

    grads = tape.gradient(class_score, conv_outputs)

    # 3. Pool gradients across spatial dimensions and weight the feature maps
    pooled_grads = tf.reduce_mean(grads, axis=(0, 1, 2))
    conv_outputs = conv_outputs[0]
    heatmap = conv_outputs @ pooled_grads[..., tf.newaxis]
    heatmap = tf.squeeze(heatmap)

    # 4. Apply ReLU and normalize between 0 and 1
    heatmap = tf.maximum(heatmap, 0) / (tf.math.reduce_max(heatmap) + 1e-8)
    heatmap = cv2.resize(heatmap.numpy(), (img_array.shape[2], img_array.shape[1]))
    return heatmap
பயிற்சி பெற்ற CNN ஐ export செய்தலும் deploy செய்தலும்
பயிற்சி frameworks, backpropagation க்காக உள்ள கனமான சார்புகளைக் கொண்டுள்ளன. உற்பத்திக்கு, model ஐ இலகுவான, inference-only வடிவத்துக்கு export செய்கிறீர்கள்.
ONNX (Open Neural Network Exchange)
ONNX என்பது, PyTorch (அல்லது TensorFlow) இல் ஒரு model ஐப் பயிற்றுவித்து, PyTorch நிறுவப்படாமலேயே ONNX Runtime, C++, C# அல்லது web browsers இல் எங்கும் ஓட்ட உதவும் திறந்த நிலையான வடிவம். PyTorch export உம் inference உம்:
import torch
import onnxruntime as ort
import numpy as np

# 1. Export trained PyTorch model to .onnx file
model.eval()
dummy_input = torch.randn(1, 3, 224, 224)
torch.onnx.export(
    model,
    dummy_input,
    "cnn_model.onnx",
    input_names=["input"],
    output_names=["output"],
    dynamic_axes={"input": {0: "batch_size"}, "output": {0: "batch_size"}}
)

# 2. Run fast inference with ONNX Runtime (no PyTorch required)
session = ort.InferenceSession("cnn_model.onnx")
sample_image = np.random.randn(1, 3, 224, 224).astype(np.float32)
predictions = session.run(["output"], {"input": sample_image})[0]
TensorFlow Lite (LiteRT)
TensorFlow Lite என்பது மொபைல் தொலைபேசிகள் (iOS, Android), Raspberry Pi, microcontrollers க்கான Google இன் இலகுவான inference இயந்திரம். இது quantization ஐ, அதாவது 32-bit floats ஐ 8-bit முழுஎண்களாகச் சுருக்குவதை, ஆதரிக்கிறது; இது model கோப்பு அளவை 75% வரை குறைத்து inference ஐ வேகப்படுத்துகிறது. TensorFlow மாற்றமும் inference உம்:
import tensorflow as tf
import numpy as np

# 1. Convert Keras model to TFLite with default optimizations (quantization)
converter = tf.lite.TFLiteConverter.from_keras_model(keras_model)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_model = converter.convert()

# Save to disk
with open("cnn_model.tflite", "wb") as f:
    f.write(tflite_model)

# 2. Run inference using the lightweight TFLite Interpreter
interpreter = tf.lite.Interpreter(model_path="cnn_model.tflite")
interpreter.allocate_tensors()
input_details = interpreter.get_input_details()
output_details = interpreter.get_output_details()

sample_image = np.random.randn(1, 224, 224, 3).astype(np.float32)
interpreter.set_tensor(input_details[0]['index'], sample_image)
interpreter.invoke()
predictions = interpreter.get_tensor(output_details[0]['index'])
இலக்குச் சாதனமும் முழுமையான திட்டச் சரிபார்ப்புப் பட்டியலும்
வெவ்வேறு deployment சூழல்களுக்கு நினைவகம், மின்கல ஆயுள், latency மீது கடுமையான வரம்புகள் உள்ளன. சரியான CNN கட்டமைப்பை முன்னதாகவே தெரிவு செய்வது பின்னர் செயல்திறன் தடைகளைத் தவிர்க்கும்; ஆகவே சாதன வரம்புகள் கட்டமைப்புத் தெரிவு முதல் இறுதி deployment வரை ஒவ்வொரு முடிவையும் வடிவமைக்கின்றன.
1. இலக்குச் சாதனமும் கட்டமைப்பு உத்தியும்
| இலக்குச் சூழல் | பரிந்துரைக்கப்படும் CNN backbone | Export வடிவம் | முதன்மை optimization இலக்கு |
|---|---|---|---|
| Cloud / Web API (GPU அல்லது பல-core CPU சேவையகம்) | ResNet-50, ConvNeXt அல்லது EfficientNet-B4 | ONNX அல்லது TensorRT | உயர் throughput (பல பயனர் கோரிக்கைகளை ஒரே நேரத்தில் batch செய்தல்), உச்சத் துல்லியம். |
| மொபைல் செயலி (iOS / Android ஸ்மார்ட்போன்கள்) | MobileNetV3 அல்லது EfficientNet-Lite | TFLite (LiteRT) அல்லது Core ML | சிறிய செயலிப் பதிவிறக்க அளவு (15 MB க்குக் கீழ்), குறைந்த மின்கலப் பயன்பாடு. |
| Edge சாதனம் (Raspberry Pi, Jetson அல்லது microcontrollers) | MobileNetV2, ShuffleNet அல்லது Tiny-YOLO | TFLite (INT8) அல்லது ONNX Runtime | குறைந்தபட்ச RAM பயன்பாடு, இணைய இணைப்பின்றி நிகழ்நேர frame rate. |
2. ஐந்து கட்டச் சரிபார்ப்புப் பட்டியல்
எந்த computer vision திட்டத்தையும் raw தரவிலிருந்து உற்பத்தி வரை கொண்டுசெல்ல, இந்த ஐந்து கட்டங்களையும் வரிசையாகப் பின்பற்றுங்கள்.
கட்டம் 1: தரவு சேகரிப்பும் அடிப்படை அமைப்பும்
- உள்ளீட்டு விவரக்குறிப்புகளை வரையறுங்கள்: நிலையான உள்ளீட்டுத் தெளிவுத்திறனையும் (உதாரணமாக நிலையான classification க்கு 224×224, அதிவேக edge சாதனங்களுக்கு 128×128) நிற வடிவத்தையும் (RGB அல்லது grayscale) உறுதிப்படுத்துங்கள்.
- வகுப்புச் சமநிலையைத் தணிக்கை செய்யுங்கள்: ஏதேனும் வகை மற்றவற்றை விட மிகக் குறைவான படங்களைக் கொண்டிருக்கிறதா என்று பார்த்து, தேவைப்பட்டால் class weights அல்லது இலக்கு வைத்த data augmentation ஐப் பயன்படுத்துங்கள்.
- சுத்தமான பிரிப்புகளை உருவாக்குங்கள்: data leakage ஐத் தடுக்க, எந்த augmentation க்கும் முன் தரவை Train (70%), Validation (15%), Test (15%) எனப் பிரியுங்கள்.
கட்டம் 2: model prototyping உம் transfer learning உம்
- Pretrained backbone உடன் தொடங்குங்கள்: ஆரம்பத்திலிருந்து பயிற்றுவிக்காமல், உங்கள் இலக்குச் சாதனத்துக்குப் பொருந்தும் pretrained model ஐ, உதாரணமாக மொபைலுக்கு MobileNetV3, web சேவையகத்துக்கு ResNet-50, ஏற்றுங்கள்.
- முதலில் classification head ஐப் பயிற்றுவியுங்கள்: convolutional base ஐ freeze செய்து, validation loss நிலைபெறும் வரை 5 முதல் 10 epochs க்கு உங்கள் புதிய dense layers ஐ மட்டும் பயிற்றுவியுங்கள்.
- மேல் layers ஐ fine-tune செய்யுங்கள்: இறுதி ஒன்று அல்லது இரண்டு convolutional blocks ஐ unfreeze செய்து, உயர்நிலை அம்சங்களை உங்கள் தரவுத்தொகுதிக்கு ஏற்பச் சரிசெய்ய மிகக் குறைந்த learning rate உடன் (உதாரணமாக 1e-5) பயிற்றுவியுங்கள்.
கட்டம் 3: validation உம் பிழைத் தணிக்கையும்
- Confusion matrices ஐச் சரிபாருங்கள்: எந்த வகுப்பு இணைகளை model அடிக்கடி குழப்புகிறது என்பதைக் கண்டறிந்து, அந்த விளிம்பு நிலைகளுக்கு மேலும் பயிற்சி எடுத்துக்காட்டுகளைச் சேகரியுங்கள்.
- Grad-CAM மாதிரிச் சோதனைகளை ஓட்டுங்கள்: தவறாக வகைப்படுத்தப்பட்ட 10 முதல் 20 validation படங்களின் மீது Grad-CAM heatmaps ஐப் பொருத்தி, model பின்னணிக் குறைபாடுகளை அல்லாமல் பொருளின் மீதே கவனம் செலுத்துகிறதா என்று உறுதிப்படுத்துங்கள்.
- ஒதுக்கி வைத்த test தொகுதியில் சரிபாருங்கள்: நிஜ உலகத் துல்லியத்தை உறுதிப்படுத்த, தொடப்படாத test தொகுதியில் ஒரே ஓர் இறுதி மதிப்பீட்டை ஓட்டுங்கள்.
கட்டம் 4: சுருக்கமும் வடிவ export உம்
- Runtime வடிவத்துக்கு export செய்யுங்கள்: உங்கள் PyTorch அல்லது Keras weights ஐ ONNX, TFLite அல்லது Core ML ஆக மாற்றுங்கள்.
- Post-training quantization ஐப் பயன்படுத்துங்கள்: 32-bit floating-point weights ஐ FP16 ஆக (அரைத் துல்லியம், குறைந்தபட்சத் துல்லிய இழப்பு) அல்லது INT8 ஆக (முழுஎண் துல்லியம், மொபைல், edge CPU களில் 4 மடங்கு சிறியதும் வேகமானதும்) மாற்றுங்கள்.
- Export செய்த துல்லியத்தைச் சரிபாருங்கள்: சுருக்கம் துல்லியத்தைக் குறைக்கவில்லை என்பதை உறுதிப்படுத்த, உங்கள் test தொகுதியை export செய்த .onnx அல்லது .tflite கோப்பு வழியாக ஓட்டுங்கள்.
கட்டம் 5: deployment உம் உற்பத்தி ஒருங்கிணைப்பும்
- Web API க்கு: ONNX Runtime session ஐ FastAPI போன்ற இலகுவான Python framework க்குள் சுற்றி, Docker கொண்டு containerize செய்து, பட upload களை ஏற்று JSON நிகழ்தகவுகளைத் திருப்பும் /predict endpoint ஐ வெளிப்படுத்துங்கள்.
- மொபைல் செயலிக்கு: .tflite அல்லது .mlpackage கோப்பை நேரடியாக உங்கள் செயலிச் சொத்துக்களுக்குள் இணைத்து, native Swift அல்லது Kotlin bindings, அல்லது Flutter அல்லது React Native plugins மூலம் சாதனத்திலேயே inference ஐ ஓட்டுங்கள்.
- Edge சாதனத்துக்கு: OpenCV கொண்டு நேரடிக் கேமரா சட்டங்களைப் பிடித்து, தொடர்ச்சியான loop இல் pixels ஐ resize செய்து normalize செய்து, tensors ஐ நேரடியாக TFLite Interpreter அல்லது NVIDIA TensorRT இயந்திரத்துக்குள் செலுத்துங்கள்.
FastAPI உம் ONNX உம் கொண்ட web சேவையகம் (நேரடி REST API)
இந்த வார்ப்புரு உற்பத்திக்குத் தயாரான REST API ஐ உருவாக்குகிறது. அது உங்கள் export செய்த .onnx model ஐத் தொடக்கத்தில் ஒரே முறை ஏற்றி, /predict endpoint இல் upload செய்யப்பட்ட படங்களை ஏற்று, முன்செயலாக்கி, JSON வகுப்புக் கணிப்புகளைத் திருப்புகிறது. முதலில் தேவையானவற்றை நிறுவுங்கள்:
pip install fastapi uvicorn onnxruntime pillow numpy python-multipartபின்னர் app.py, முழு API சேவையகம்:
from fastapi import FastAPI, File, UploadFile, HTTPException
import onnxruntime as ort
import numpy as np
from PIL import Image
import io

app = FastAPI(title="CNN Image Classifier API")

# 1. Load ONNX model once when the server starts
MODEL_PATH = "cnn_model.onnx"
session = ort.InferenceSession(MODEL_PATH, providers=["CPUExecutionProvider"])
input_name = session.get_inputs()[0].name
output_name = session.get_outputs()[0].name

# Replace with your actual class labels
CLASS_NAMES = ["Class_0", "Class_1", "Class_2", "Class_3", "Class_4"]

def preprocess_image(image_bytes: bytes) -> np.ndarray:
    """Resizes, normalizes, and formats an image into a [1, 3, 224, 224] float32 tensor."""
    image = Image.open(io.BytesIO(image_bytes)).convert("RGB")
    image = image.resize((224, 224))

    # Convert to numpy array and scale pixels to [0, 1]
    img_array = np.array(image, dtype=np.float32) / 255.0

    # Standard ImageNet normalization
    mean = np.array([0.485, 0.456, 0.406], dtype=np.float32)
    std = np.array([0.229, 0.224, 0.225], dtype=np.float32)
    img_array = (img_array - mean) / std

    # Rearrange from (H, W, C) to (C, H, W) and add batch dimension -> (1, 3, 224, 224)
    img_array = np.transpose(img_array, (2, 0, 1))
    return np.expand_dims(img_array, axis=0)

def softmax(logits: np.ndarray) -> np.ndarray:
    exp_scores = np.exp(logits - np.max(logits))
    return exp_scores / np.sum(exp_scores)

@app.post("/predict")
async def predict(file: UploadFile = File(...)):
    if not file.content_type.startswith("image/"):
        raise HTTPException(status_code=400, detail="Uploaded file must be an image.")

    image_bytes = await file.read()
    input_tensor = preprocess_image(image_bytes)

    # Run ONNX inference
    outputs = session.run([output_name], {input_name: input_tensor})
    probabilities = softmax(outputs[0][0])
    predicted_idx = int(np.argmax(probabilities))

    return {
        "predicted_class": CLASS_NAMES[predicted_idx],
        "confidence": round(float(probabilities[predicted_idx]), 4),
        "all_probabilities": {
            CLASS_NAMES[i]: round(float(probabilities[i]), 4) for i in range(len(CLASS_NAMES))
        }
    }

# Run the server from your terminal with:
# uvicorn app:app --host 0.0.0.0 --port 8000
Raspberry Pi உம் OpenCV உம் கொண்ட நேரடி webcam script (TFLite)
இந்த script, OpenCV கொண்டு USB webcam அல்லது Pi Camera இலிருந்து இடைவிடாமல் சட்டங்களைப் பிடித்து, quantize செய்த .tflite model உடன் இலகுவான inference ஐ ஓட்டி, நேரடிக் கணிப்பையும் FPS ஐயும் video ஓடையின் மேல் காட்டுகிறது. முதலில் தேவையானவற்றை நிறுவுங்கள்:
pip install opencv-python-headless numpy tflite-runtimeபின்னர் edge_webcam_inference.py, முழு edge script:
import cv2
import numpy as np
import time

# Use tflite_runtime on Raspberry Pi, or fall back to full tensorflow on desktop
try:
    import tflite_runtime.interpreter as tflite
except ImportError:
    import tensorflow.lite as tflite

# 1. Initialize TFLite Interpreter (use 4 threads on Raspberry Pi 4/5)
MODEL_PATH = "cnn_model.tflite"
interpreter = tflite.Interpreter(model_path=MODEL_PATH, num_threads=4)
interpreter.allocate_tensors()

input_details = interpreter.get_input_details()
output_details = interpreter.get_output_details()
input_shape = input_details[0]['shape']  # e.g., [1, 224, 224, 3]
height, width = input_shape[1], input_shape[2]
is_quantized = (input_details[0]['dtype'] == np.uint8)

CLASS_NAMES = ["Class_0", "Class_1", "Class_2", "Class_3", "Class_4"]

# 2. Open webcam stream (0 is usually the default USB/built-in camera)
cap = cv2.VideoCapture(0)
if not cap.isOpened():
    raise RuntimeError("Could not open webcam.")

print("Starting live inference. Press 'q' to quit.")

while True:
    start_time = time.time()
    ret, frame = cap.read()
    if not ret:
        break

    # 3. Preprocess frame (OpenCV uses BGR, convert to RGB)
    rgb_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
    resized = cv2.resize(rgb_frame, (width, height))

    if is_quantized:
        input_data = np.expand_dims(resized, axis=0).astype(np.uint8)
    else:
        input_data = np.expand_dims(resized.astype(np.float32) / 255.0, axis=0)

    # 4. Run TFLite inference
    interpreter.set_tensor(input_details[0]['index'], input_data)
    interpreter.invoke()
    predictions = interpreter.get_tensor(output_details[0]['index'])[0]

    # 5. Extract top prediction and calculate FPS
    top_idx = int(np.argmax(predictions))
    confidence = float(predictions[top_idx])
    if is_quantized:
        confidence /= 255.0  # Rescale uint8 output to 0.0 - 1.0

    fps = 1.0 / (time.time() - start_time)
    label_text = f"{CLASS_NAMES[top_idx]} ({confidence*100:.1f}%) | FPS: {fps:.1f}"

    # 6. Draw overlay onto the display frame
    cv2.rectangle(frame, (10, 10), (480, 50), (0, 0, 0), -1)
    cv2.putText(frame, label_text, (20, 38), cv2.FONT_HERSHEY_SIMPLEX, 0.7, (0, 255, 0), 2)

    cv2.imshow("Edge CNN Inference", frame)
    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

cap.release()
cv2.destroyAllWindows()
Docker கொண்டு FastAPI சேவையகத்தை containerize செய்தல்
உங்கள் FastAPI சேவையகத்தை containerize செய்வது, உங்கள் Python சூழல், ONNX Runtime, பயிற்சி பெற்ற model ஆகியவற்றை எந்த cloud வழங்குநரிலும் ஒரே மாதிரி ஓடும் கையடக்கப் படிமமாக்குகிறது. container ஐக் கட்டுவதற்கு முன், உங்கள் கோப்புகளை ஒரே திட்டக் கோப்புறைக்குள் வைத்திருங்கள்:
cnn-api/
├── app.py               # Your FastAPI server code
├── cnn_model.onnx       # Your exported ONNX model
├── requirements.txt     # Python dependencies
└── Dockerfile           # Container build instructions
requirements.txt:
fastapi==0.115.0
uvicorn==0.30.6
onnxruntime==1.19.2
pillow==10.4.0
numpy==1.26.4
python-multipart==0.0.12
உற்பத்தி Dockerfile, cloud deployment இன்போது container சிறியதாகவும் விரைவாகப் பதிவிறக்கப்படுவதாகவும் இருக்க, மெல்லிய Python base படிமத்தைப் பயன்படுத்துகிறது:
# Use an official lightweight Python runtime
FROM python:3.11-slim

# Prevent Python from writing .pyc files and enable unbuffered logs
ENV PYTHONDONTWRITEBYTECODE=1
ENV PYTHONUNBUFFERED=1

# Set the working directory inside the container
WORKDIR /app

# Install system dependencies needed by Pillow
RUN apt-get update && apt-get install -y --no-install-recommends \
    libjpeg62-turbo-dev \
    zlib1g-dev \
    && rm -rf /var/lib/apt/lists/*

# Copy and install Python dependencies first (caches layer for faster rebuilds)
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copy your FastAPI code and exported ONNX model into the container
COPY app.py .
COPY cnn_model.onnx .

# Expose port 8000 for incoming HTTP traffic
EXPOSE 8000

# Start the Uvicorn server
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
இந்தக் கட்டளைகளை உங்கள் cnn-api/ கோப்பகத்துக்குள் இருந்து ஓட்டுங்கள். படி 1, container ஐக் கட்டி இயக்குங்கள்:
# Build the Docker image
docker build -t cnn-classifier-api .

# Run the container locally, mapping port 8000 on your machine to port 8000 in Docker
docker run -d -p 8000:8000 --name cnn-service cnn-classifier-api
படி 2, ஓடும் container க்கு ஒரு மாதிரிப் படத்தை (test_image.jpg) POST கோரிக்கையில் அனுப்பி, cURL மூலம் endpoint ஐச் சோதியுங்கள்:
curl -X POST "http://localhost:8000/predict" \
     -H "accept: application/json" \
     -H "Content-Type: multipart/form-data" \
     -F "file=@test_image.jpg;type=image/jpeg"
எதிர்பார்க்கப்படும் JSON பதில்:
{
    "predicted_class": "Class_2",
    "confidence": 0.9412,
    "all_probabilities": {
        "Class_0": 0.0105,
        "Class_1": 0.0241,
        "Class_2": 0.9412,
        "Class_3": 0.0150,
        "Class_4": 0.0092
    }
}
நிறைவுரை
CNN சிறிய கருத்துக்களின் தொகுதியால் கட்டப்படுகிறது: convolution, ReLU, pooling, மேலே ஒரு dense classifier; parameter sharing உம் local connectivity உம் கனமான வேலையைச் செய்கின்றன. அந்த அடித்தளத்திலிருந்து, ResNet உம் U-Net உம் ஆழத்தையும் தெளிவுத்திறனையும் தீர்க்கின்றன, transfer learning தரவையும் நேரத்தையும் சேமிக்கிறது, Grad-CAM model ஐ நேர்மையாக வைத்திருக்கிறது, ONNX, TFLite, FastAPI, Docker ஆகியவை அதை notebook இலிருந்து சேவையகம், தொலைபேசி அல்லது கேமராவுக்குக் கொண்டுசெல்கின்றன.