Deep Learning இன் வரலாறு: செயற்கை நியூரான்களிலிருந்து Foundation Models, Reasoning Systems, Embodied AI வரை
இந்த வரலாற்றை எப்படி வாசிப்பது
Deep learning ChatGPT, Transformer அல்லது AlexNet உடன் தொடங்கவில்லை. அது நரம்பியல், கணிதம், கணினி அறிவியல், புள்ளியியல், பொறியியல் ஆகியவற்றில் பல பத்தாண்டுகள் நடந்த வேலையிலிருந்து தோன்றியது. அதன் வளர்ச்சி ஒருபோதும் நேர்கோட்டில் இருந்ததில்லை: நம்பிக்கை தந்த யோசனைகள் பெரும்பாலும் சிறந்த algorithms, அதிக தரவு, கட்டுப்படியான கணிப்பீடு, நம்பவைக்கும் பயன்பாடுகளுக்காகக் காத்திருக்க வேண்டியிருந்தது.
இந்த வழிகாட்டி வரலாற்றுத் தொடர்புகளை விரிவாக்கி, மிகையான கூற்றுகளைத் திருத்துகிறது. காலவரிசையைத் தொடர்ந்து தொழில்நுட்ப விளக்கங்கள், நடைமுறைக் கற்றல் பயிற்சிகள், சொற்களஞ்சியம் வருகின்றன. திகதிகள் பொதுவாக ஒரு மூல ஆய்வுக் கட்டுரையை அல்லது பொது ஆய்வு மைல்கல்லையே குறிக்கின்றன; முதல் தனிப்பட்ட பரிசோதனையையோ பிற்கால product வெளியீட்டையோ அவசியம் குறிப்பதில்லை.
எந்த ஒரு கட்டுரையும் ஒவ்வொரு ஆய்வுக் கட்டுரையையும், கண்டுபிடிப்பாளரையும், வணிக அமைப்பையும் உள்ளடக்க முடியாது. இங்கே “விரிவான” என்பது முக்கிய வரலாற்று இழைகளை உள்ளடக்குவதையே குறிக்கிறது; சொல்லுக்குச் சொல் முழுமையான முன்னுரிமையையோ தொடர்ந்து புதுப்பிக்கப்படும் தரவரிசையையோ உரிமை கோரவில்லை. அண்மைய அமைப்புகள் ஆய்வுத் திசைகளுக்கான காலக்குறிப்புள்ள எடுத்துக்காட்டுகளே; ஒரு குறிப்பிட்ட model தற்போது சிறந்தது என்ற கூற்றுகள் அல்ல.
1. Deep learning என்றால் உண்மையில் என்ன
செயற்கை நுண்ணறிவு (AI) என்பது நுண்ணறிவுடன் தொடர்புடைய பணிகளைச் செய்யும் அமைப்புகளை உருவாக்கும் பரந்த இலக்கு. Machine learning அதற்கான ஒரு வழி: முழுவதும் கையால் எழுதிய விதிகளைச் சார்ந்திராமல், அமைப்புகள் எடுத்துக்காட்டுகளிலிருந்து வடிவங்களைக் கற்கின்றன. Deep learning என்பது கற்ற representation இன் பல நிலைகளைப் பயன்படுத்தும் machine-learning முறைகளின் குடும்பம்.
ஒரு பட model, pixels ஐ விளிம்புகள், அமைப்புகள், பாகங்கள், பணிக்குப் பொருத்தமான representations ஆக மாற்றலாம். ஒரு language model, tokens இன் representations ஐயும் அவற்றின் தொடர்புகளையும் கற்கிறது. இவை பயனுள்ள உள்ளுணர்வுகளே; ஒவ்வொரு layer உம் தெளிவான, மனிதர் வாசிக்கக்கூடிய கருத்துடன் ஒத்துப்போகும் என்பதற்கான உத்தரவாதம் அல்ல. Deep networks இல் feedforward, convolutional, recurrent, attention-based, graph-based, கலப்புக் கட்டமைப்புகள் அடங்கும். (LeCun, Bengio and Hinton, 2015.)
நான்கு வேறுபாடுகள் பெரும் குழப்பத்தைத் தடுக்கின்றன:
- Architecture என்பது CNN அல்லது Transformer போன்ற model இன் கட்டமைப்பு.
- Learning objective என்பது labels ஐக் கணித்தல், தரவை மீளுருவாக்குதல், அடுத்த token ஐக் கணித்தல் போன்ற, பயிற்சி எதற்குப் பரிசளிக்கிறது என்பது.
- Optimisation என்பது அந்த objective ஐ மேம்படுத்த parameters எப்படிச் சரிசெய்யப்படுகின்றன என்பது.
- System design என்பது model ஐச் சுற்றியுள்ள retrieval, tools, memory, அனுமதிகள், deployment ஆகியவற்றை உள்ளடக்கும்.
ஆகவே AI agent என்பது புதிய neural architecture ஆக இருக்க வேண்டியதில்லை. அது ஒரு மென்பொருள் கட்டுப்பாட்டு loop க்குள் பொருத்தப்பட்ட language model ஆகவும் இருக்கலாம்.
2. அடித்தளங்கள்: 1940 கள் முதல் 1960 களின் தொடக்கம் வரை
1943: McCulloch உம் Pitts உம்
Warren McCulloch உம் Walter Pitts உம் threshold logic ஐப் பயன்படுத்தி ஒரு நியூரானின் கணிதச் சுருக்கத்தை விவரித்தனர். இந்த இலட்சிய அலகுகளின் networks தர்க்கக் கணிப்புகளை வெளிப்படுத்த முடிந்தது. இது அடித்தளமானது; ஆனால் இது நவீன, பயிற்றுவிக்கக்கூடிய deep network அல்ல; உயிரியல் மூளையின் உண்மையான உருவகப்படுத்தலும் அல்ல.
1949: Hebbian learning
மீண்டும் மீண்டும் இணைந்து நடக்கும் செயற்பாடு நியூரான்களுக்கு இடையிலான இணைப்புகளை வலுப்படுத்தலாம் என்று Donald Hebb முன்மொழிந்தார். பழக்கமான “neurons that fire together wire together” என்ற சொற்றொடர் பிற்காலச் சுருக்கமே; அவருடைய நூலிலிருந்து (The Organization of Behavior) எடுத்த சரியான மேற்கோள் அல்ல. Hebbian கருத்துக்கள் associative learning, self-organisation, பிற்கால neural-network ஆய்வுகளைப் பாதித்தன.
1957–1958: Rosenblatt உம் perceptron உம்
Frank Rosenblatt, சரிசெய்யக்கூடிய weights கொண்ட, செல்வாக்குள்ள கற்றல் model ஆன perceptron ஐ உருவாக்கினார். அதன் அடிப்படை classifier, உள்ளீடுகளின் எடையிட்ட கூட்டுத்தொகையைக் கணக்கிட்டு ஒரு threshold ஐப் பயன்படுத்துகிறது. வகைப்படுத்தல் பிழைகளுக்கு ஏற்ப weights ஐப் பயிற்சி மாற்றுகிறது. ஒரே நேரியல் முடிவு எல்லை, நேரியலாகப் பிரிக்கக்கூடிய வகைப்படுத்தல் பிரச்சினைகளைத் தீர்க்கும்; ஆனால் சாத்தியமான எல்லா உறவுகளையும் அல்ல. (Rosenblatt, 1958.)
ஏறத்தாழ 1960: ADALINE உம் adaptive filtering உம்
Bernard Widrow உம் Marcian Hoff உம் ADALINE ஐயும் least-mean-squares கற்றல் விதியையும் உருவாக்கினர். இது adaptive neural அமைப்புகளைப் பிழைக் குறைப்புடனும் நடைமுறைச் சமிக்ஞைச் செயலாக்கத்துடனும் இணைத்தது. Perceptron விதியும் Widrow–Hoff விதியும் வரலாற்றுரீதியாகத் தொடர்புடையவை; ஆனால் ஒரே algorithm அல்ல. (Widrow and Hoff.)
3. ஆழம், வரம்புகள், ஆரம்பத் தடைகள்: 1960 களும் 1970 களும்
Ivakhnenko உம் Lapa உம்: பல-layer அமைப்புகளைக் கற்றல்
Alexey Ivakhnenko உம் Valentin Lapa உம் 1960 களில் ஆரம்பகாலப் பல-layer polynomial மாதிரியாக்க முறைகளை உருவாக்கினர். தொடர்புடைய Group Method of Data Handling, உள்ளீடுகளினதும் இடைநிலை அம்சங்களினதும் பயனுள்ள சேர்க்கைகளைத் தெரிவுசெய்து, models ஐப் படிப்படியாகக் கட்டியது. இவை deep learning இன் முக்கிய முன்னோடிகள்; ஆனால் இவற்றை இன்றைய end-to-end backpropagation-இல் பயிற்றுவிக்கப்படும் MLP களுடன் ஒன்றென விவரிப்பது கணிசமான வேறுபாடுகளை மறைக்கும். (Ivakhnenko, Polynomial Theory of Complex Systems, 1971.)
1969: Perceptrons எதை நிரூபித்தது, எதை நிரூபிக்கவில்லை
Marvin Minsky உம் Seymour Papert உம் perceptron அமைப்புகளின் முக்கிய வரம்புகளை ஆய்ந்தனர். XOR எடுத்துக்காட்டு, ஒரே நேரியல் threshold அலகின் அடிப்படை வரம்பைக் காட்டுகிறது: அதன் நேர், எதிர் எடுத்துக்காட்டுகளை ஒரே நேர்கோட்டு எல்லையால் பிரிக்க முடியாது.
சரியான பாடம் “neural networks வேலை செய்யாது” என்பது அல்ல. மறைந்த nonlinear மாற்றங்களைச் சேர்ப்பது, ஒரு network எதை representation செய்ய முடியும் என்பதை மாற்றுகிறது. ஆனால் representation மட்டும் ஒரு திறமையான கற்றல் முறையைத் தருவதில்லை. (Minsky and Papert, Perceptrons.)
AI winters ஒரு நூலை விடப் பரந்தவை
ஆர்வமும் நிதியும் குறைந்த காலங்கள், நிறைவேறாத வாக்குறுதிகள், செலவான கணிப்பீடு, வரையறுக்கப்பட்ட தரவு, பல AI அணுகுமுறைகளிலும் ஏமாற்றம் தந்த நடைமுறை முடிவுகள் ஆகியவற்றைப் பிரதிபலித்தன. Neural-network மீதான சந்தேகம் இந்தக் கதையின் ஒரு பகுதி; ஆனால் முதல் அல்லது இரண்டாவது AI winter ஐ ஒரு நூலுக்கோ ஒரு algorithm க்கோ பொறுப்புடன் ஆட்படுத்த முடியாது. வீழ்ச்சிக் காலங்களிலும் ஆய்வு தொடர்ந்தது; துறை மறைந்துவிட்டுப் பின்னர் பூச்சியத்திலிருந்து மீளத் தொடங்கவில்லை.
1986 திருப்புமுனைக்கு முன் reverse-mode differentiation
calculus இன் chain rule, neural networks க்கு நீண்ட காலம் முந்தையது. Reverse-mode automatic differentiation ஒரு பொதுக் கணிப்பு முறையாக உருவானது; Seppo Linnainmaa வின் 1970 வேலை ஒரு மைல்கல். Paul Werbos இன் 1974 ஆய்வேடு, derivative அடிப்படையிலான கற்றலைப் பல-layer அமைப்புகளுடன் இணைத்தது. backpropagation பின்னர் பிரபலமானது பற்றிப் பேசும்போது இந்த வேர்கள் முக்கியம். (Linnainmaa, 1976 இதழ் வெளியீடு; backpropagation குறித்த Werbos இன் மீள்பார்வை.)
4. Neural networks இன் மறுமலர்ச்சி: 1980–1989
1980: Fukushima வின் neocognitron
Kunihiko Fukushima, பார்வை நரம்பியலால் ஊக்கம் பெற்ற படிநிலைக் காட்சி அடையாளக் கட்டமைப்பான neocognitron ஐ அறிமுகப்படுத்தினார். மாறி மாறி வரும் feature-detection, pooling போன்ற நிலைகள், பட நிலை மாற்றங்களுக்குத் தாங்கும் தன்மையைத் தந்தன. அது convolutional neural networks இன் முக்கிய முன்னோடி; ஆனால் அதன் அசல் கற்றல் முறை நவீன supervised backpropagation செய்முறை அல்ல. பரவலாக மேற்கோள் காட்டப்படும் இதழ்க் கட்டுரை 1980 இல் வெளியானது.
1982–1985: associative memory உம் energy-based கற்றலும்
John Hopfield, energy-function பார்வையைப் பயன்படுத்தி recurrent networks ஐ associative memories ஆகச் செயல்பட வைக்க முடியும் என்று காட்டினார். பின்னர் Boltzmann machines, David Ackley, Geoffrey Hinton, Terrence Sejnowski ஆகியோரின் செல்வாக்குள்ள கற்றல் கட்டுரையுடன், stochastic energy-based கற்றலை அறிமுகப்படுத்தின. இந்த இழைகள், நேரடியான உள்ளீடு-to-label வகைப்படுத்தலுக்கு அப்பால் neural கணிப்பை விரிவாக்கின. (Hopfield, 1982; Ackley, Hinton and Sejnowski, 1985.)
1986: backpropagation பரவலாகச் செல்வாக்குப் பெறுகிறது
David Rumelhart, Geoffrey Hinton, Ronald Williams ஆகியோர், பிழை derivatives ஐப் பின்னோக்கிப் பரப்புவதன் மூலம் பல-layer networks பயனுள்ள உள் representations ஐக் கற்க முடியும் என்று காட்டினர். அவர்களின் கட்டுரை ஒரு தீர்மானமான தொடர்பாடல், பரிசோதனை மைல்கல்; chain rule இன் தனிப்பட்ட கண்டுபிடிப்போ backpropagation இன் ஒரே மூலமோ அல்ல.
பயிற்சிச் சுழற்சி:
- ஒரு கணிப்பைப் பெற forward pass ஐ ஓட்டுங்கள்.
- இலக்கு அல்லது objective உடன் முரண்பாட்டை அளக்கும் loss ஐக் கணக்கிடுங்கள்.
- Parameters ஐப் பொறுத்து அந்த loss இன் derivatives ஐக் கணக்கிட backpropagation ஐப் பயன்படுத்துங்கள்.
- Parameters ஐப் புதுப்பிக்க stochastic gradient descent போன்ற optimiser ஐப் பயன்படுத்துங்கள்.
Backpropagation gradients ஐக் கணக்கிடுகிறது. Optimiser புதுப்பிப்புகளைப் பயன்படுத்துகிறது. அவை வெவ்வேறு செயல்பாடுகள்.
1989: convolutional networks நடைமுறைக்கு வருகின்றன
Yann LeCun உம் சகாக்களும் கையால் எழுதிய ZIP-code அடையாளத்துக்கு ஒரு convolutional network ஐப் பயிற்றுவித்தனர். உள்ளூர் இணைப்பும் பகிரப்பட்ட weights உம், ஒரு படத்தை fully connected ஆகக் கையாள்வதோடு ஒப்பிடும்போது parameters இன் எண்ணிக்கையைக் குறைத்தன. இது முந்தைய படிநிலைப் பார்வை models க்கும் பயன்படுத்தக்கூடிய வடிவ அடையாளத்துக்கும் இடையிலான முக்கிய பாலம். (LeCun and colleagues, 1989.)
5. தொடர்வரிசைக் கற்றலும் நிலைத்த தடைகளும்: 1990 கள்
Recurrent neural networks, ஒரு தொடர்வரிசையினூடாக மாறும் நிலையை (state) அறிமுகப்படுத்தின; அதனால் பேச்சு, மொழி, time-series பிரச்சினைகளுக்குப் பயனுள்ளவை ஆயின. Backpropagation through time, ஒரு recurrent கணிப்பைக் காலப் படிகளினூடாக விரித்துப் பயிற்றுவிக்கிறது. Elman networks, recurrent அமைப்புகள் தொடர்வரிசைக் கட்டமைப்பை எப்படிக் கற்க முடியும் என்பதைக் காட்ட உதவின. (Elman, 1990.)
மறையும், வெடிக்கும் gradients
derivatives ஐ மீண்டும் மீண்டும் பெருக்குவது gradients ஐப் பூச்சியத்தை நோக்கிச் சுருங்கவோ அளவுக்கதிகமாக வளரவோ செய்யலாம். இது நீண்டதூரச் சார்புகளைக் கற்பதைக் கடினமாக்குகிறது. சிக்கல் கணினிகள் மெதுவாக இருந்தது மட்டுமல்ல: optimisation உம் கட்டமைப்பும் கூட முக்கியம். (Bengio, Simard and Frasconi, 1994.)
1997: Long Short-Term Memory
Sepp Hochreiter உம் Jürgen Schmidhuber உம் LSTM ஐ அறிமுகப்படுத்தினர்; நீண்டதூர credit assignment ஐ மேம்படுத்த, சிறப்பாகக் கட்டமைக்கப்பட்ட நினைவகப் பாதையைப் பயன்படுத்தினர். பிற்கால மாறுபாடுகள் forget gates உட்பட gates ஐச் சேர்த்துச் செம்மைப்படுத்தின. LSTM ஒரு முக்கிய பிரச்சினையைக் கணிசமாகத் தணித்தது; ஒவ்வொரு gradient அல்லது நினைவக வரம்பையும் முழுமையாக நீக்கவில்லை.
1998: LeNet-5 உம் ஆவண அடையாளமும்
LeCun, Léon Bottou, Yoshua Bengio, Patrick Haffner ஆகியோர், LeNet-5 உட்பட, ஆவண அடையாளத்துக்கான gradient-based கற்றலை முன்வைத்தனர். CNN அடிப்படையிலான அமைப்புகள், 2012 deep-learning எழுச்சிக்கு நீண்ட காலம் முன்பே neural முறைகள் நடைமுறைப் பயனைத் தர முடியும் என்பதை நிறுவின.
மற்ற முறைகள் ஏன் கவர்ச்சியாக இருந்தன
Support vector machines, நிகழ்தகவு models, boosting, decision trees, பின்னர் random forests பல பிரச்சினைகளில் வலுவான முடிவுகளைத் தந்தன. சிறிய தரவுத்தொகுதிகள், எளிய optimisation, கையாளக்கூடிய கணிப்பீடு ஆகியவை பெரும்பாலும் இந்த மாற்றுகளுக்குச் சாதகமாக இருந்தன. அவற்றின் வெற்றி தற்காலிகத் தவறு மட்டுமல்ல: பலவும், குறிப்பாகக் கட்டமைக்கப்பட்ட தரவுக்கும் குறைந்த தரவுப் பணிகளுக்கும், இன்றும் சிறந்த தெரிவுகளே.
6. மறுமலர்ச்சிக்கான நிலைமைகள்: 2000–2011
Neural language models உம் distributed representations உம்
Bengio உம் சகாக்களும் முன்வைத்த neural probabilistic language model, சொற்களின் representations ஐக் கற்பது, அவதானிக்கப்பட்ட சரியான தொடர்வரிசைகளுக்கு அப்பாலும் பொதுமைப்படுத்த உதவும் என்று காட்டியது. இது word embeddings ஜயும் நவீன language models ஜயும் நோக்கிய அறிவுசார் வழித்தடத்தை நிறுவ உதவியது. (Bengio and colleagues, 2003.)
2006: deep belief networks உம் pretraining உம்
Hinton, Simon Osindero, Yee-Whye Teh ஆகியோர் deep belief networks க்கான செல்வாக்குள்ள வேகமான கற்றல் அணுகுமுறையை அறிமுகப்படுத்தினர். Layerwise unsupervised pretraining, supervised செம்மைப்படுத்தலுக்கு முன் deep models ஐத் தொடக்கநிலைப்படுத்த ஒரு வழியைத் தந்தது. Autoencoder அடிப்படையிலான pretraining உம் தொடர்புடைய வேலையும் deep representations மீதான ஆர்வத்தைப் புதுப்பிக்க உதவின. பெரும்பாலான நவீன பெரிய models அதே DBN பயிற்சிச் செய்முறையைப் பயன்படுத்துவதில்லை என்றாலும், இந்த நுட்பங்கள் வரலாற்றுரீதியாக முக்கியமானவை.
2006: பிரிக்கப்படாத தொடர்வரிசைகளிலிருந்து கற்றல்
Alex Graves, Santiago Fernández, Faustino Gomez, Jürgen Schmidhuber ஆகியோர் Connectionist Temporal Classification (CTC) ஐ அறிமுகப்படுத்தினர். ஒவ்வொரு உள்ளீட்டு நேரப் படிக்கும் கையால் alignment தரத் தேவையின்றி, ஒரு உள்ளீட்டுத் தொடர்வரிசையிலிருந்தும் இலக்கு label தொடர்வரிசையிலிருந்தும் sequence models கற்க இது அனுமதித்தது. செல்லுபடியாகும் alignments மீது கூட்டுவதன் மூலம், CTC neural தொடர்வரிசைக் கற்றலையும் நடைமுறைப் பேச்சு, கையெழுத்து அடையாளத்தையும் இணைக்க உதவியது. CTC என்பது ஒரு பயிற்சி objective உம் decoding framework உம்; LSTM க்கு மாற்றுப் பெயர் அல்ல.
CUDA உம் GPU மாற்றமும்
Graphics processors, பெருமளவு இணையான எண் வேலையைச் செய்ய வடிவமைக்கப்பட்டவை. Neural-network கணிப்பின் பெரும்பகுதியை matrix செயல்பாடுகளாகவும் தொடர்புடைய tensor கணிப்புகளாகவும் வெளிப்படுத்தலாம். 2006–2007 காலத்தில் அறிமுகமான NVIDIA இன் CUDA platform, பொது நோக்க GPU நிரலாக்கத்தைக் கணிசமாக எளிதாக்கியது.
CUDA ஒரு செயல்படுத்தும் கணிப்பீட்டு platform; deep learning இன் கண்டுபிடிப்பு அல்ல. AlexNet க்கு முன்பே ஆய்வாளர்கள் neural கணிப்புக்கு GPU களைப் பயன்படுத்தினர்; Raina, Anand Madhavan, Andrew Ng ஆகியோரின் 2009 கட்டுரை GPU அடிப்படையிலான பெரிய அளவு unsupervised கற்றலுக்கான ஒரு செல்வாக்குள்ள எடுத்துக்காட்டு. (NVIDIA CUDA அறிமுகம்; Raina and colleagues, 2009.)
தரவு, benchmarks, மென்பொருள்
2009 இல் அறிமுகமான ImageNet, பெரிய labelled பட வளத்தை வழங்கியது. அதன் பிற்கால recognition challenge, அமைப்புகளை ஒப்பிட ஒரு பொது வழியை உருவாக்கியது. பெரிய தரவுத்தொகுதிகள் கற்றலைத் தானாகத் தீர்க்கவில்லை; ஆனால் அதிக ஆற்றல் கொண்ட அணுகுமுறை உண்மையில் பொதுமைப்படுத்துகிறதா என்பதைச் சோதிப்பதை எளிதாக்கின. (Deng and colleagues, ImageNet.)
சிறந்த மென்பொருள், distributed training, rectified activations, optimisation மேம்பாடுகள் அனைத்தும் பங்களித்தன. Rectified linear units AlexNet க்கு முன்பே இருந்தன; Nair உம் Hinton உம் 2010 இல் செய்த ஆய்வு போன்ற வேலை, அவற்றின் பயனை நிறுவ உதவியது. (Nair and Hinton, 2010.)
பேச்சு அடையாளமும் ஒரு முக்கிய சோதனைக் களமாகியது. Deep acoustic models அடையாள அமைப்புகளை மேம்படுத்தின; பட வகைப்படுத்தலைச் சுற்றிய பொது கவனத்துக்கு முன்பே neural முறைகளுக்கான தொழில்துறை நியாயத்தை நிறுவ உதவின. (Hinton and colleagues, 2012 மீள்பார்வை.)
7. 2012: AlexNet ஏன் துறையை மாற்றியது
Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton ஆகியோர் ImageNet இல் ஒரு பெரிய CNN ஐப் பயிற்றுவித்தனர். அந்த network பல கூறுகளை இணைத்தது: convolutional layers, ReLU activations, GPU செயலாக்கம், data augmentation, overfitting ஐக் குறைக்க dropout.
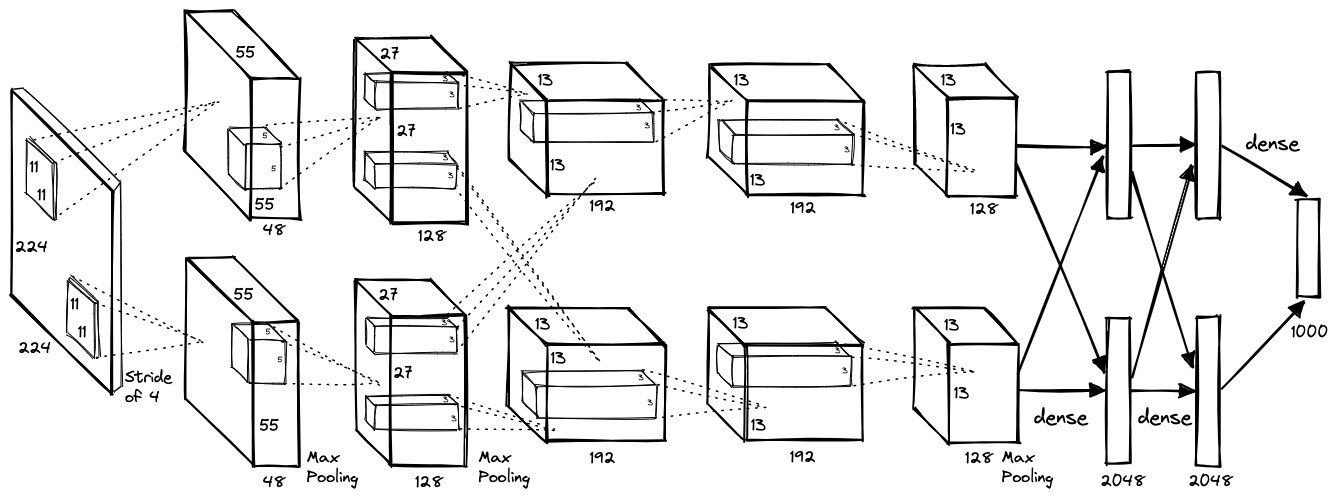
அறிவிக்கப்பட்ட கட்டமைப்பில் ஏறத்தாழ 60 மில்லியன் parameters, ஐந்து convolutional layers, மூன்று fully connected layers இருந்தன. ஒரு network ஐப் பயிற்றுவிக்க இரண்டு NVIDIA GTX 580 GPU களில் ஏறத்தாழ ஐந்து முதல் ஆறு நாட்கள் ஆயின. போட்டியில் வென்ற அமைப்பு 15.3% top-5 பிழையை அடைந்தது; இரண்டாம் இடம் 26.2%. அந்தப் போட்டி எண்ணிக்கை ஒரு ensemble ஐக் கொண்டது; அதை ஒரு தனி model இன் top-1 துல்லியமாக முன்வைக்கக் கூடாது.
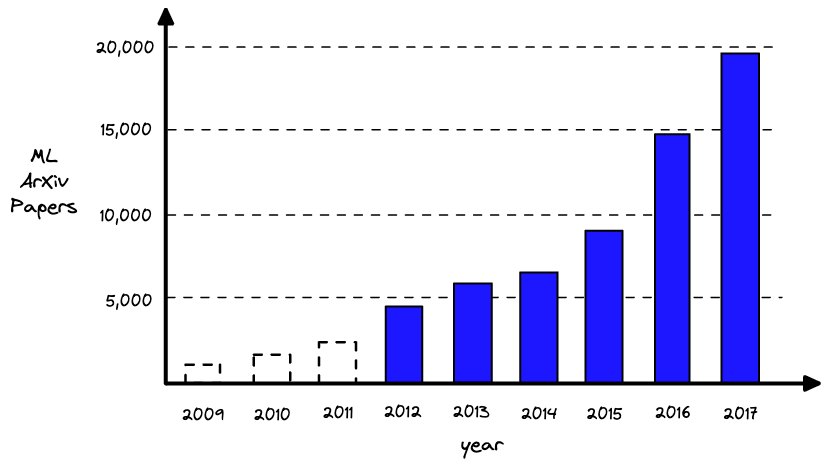
AlexNet, CNN, GPU, ReLU அல்லது காட்சி அம்சங்களைக் கற்கும் யோசனையைக் கண்டுபிடிக்கவில்லை. அதன் முக்கியத்துவம் நிரூபணத்தின் அளவும் தெளிவும். முன்பே உருவாக்கப்பட்ட பல யோசனைகளை ஆற்றலுடன் இணைத்தால், மேலோங்கியிருந்த பட-அடையாளப் pipeline ஐ வியக்கத்தக்க வித்தியாசத்தில் மிஞ்ச முடியும் என்று அது காட்டியது.
Dropout ஒரு regularisation நுட்பமாகத் தனியாகப் பெருமை பெறத் தகுதியானது: பயிற்சியின்போது அலகுகள் சீரற்ற முறையில் விடப்படுகின்றன; இது எளிதில் உடையும் co-adaptations ஐத் தடுக்கிறது. அதன் விளைவு model, பயிற்சி அமைப்பைப் பொறுத்தது; ஒவ்வொரு deep கட்டமைப்புக்கும் பொதுவான தேவை அல்ல. (Srivastava and colleagues, 2014.)
8. பார்வை, மொழி, உருவாக்கம் முழுவதும் விரிவாக்கம்: 2013–2016
Computer vision பல்வகைப்படுகிறது
VGG, சிறிய convolutional filters இலிருந்து கட்டிய ஆழமான networks இன் மதிப்பை ஆராய்ந்தது. GoogLeNet/Inception, திறனை மேம்படுத்த multi-branch கணிப்பைப் பயன்படுத்தியது. ResNet, residual learning ஐ அறிமுகப்படுத்தி, மிக ஆழமான networks ஐ optimise செய்வதை எளிதாக்கியது. U-Net உயிர்மருத்துவ segmentation இல் செல்வாக்குப் பெற்றது; R-CNN குடும்ப detectors உம் YOLO உம் பொருள் கண்டறிதலை முன்னேற்றின. பட வகைப்படுத்தல், கண்டறிதல், segmentation ஆகியவை தொடர்புடையவை; ஆனால் வெவ்வேறு பணிகள்.
Embeddings, sequence-to-sequence கற்றல், attention
Word2vec 2013 இல் திறமையான கற்ற சொல் representations ஐச் செல்வாக்குள்ளதாக்கியது. Sequence-to-sequence models, மொழிபெயர்ப்பு போன்ற பணிகளுக்கு neural encoders, decoders ஐப் பயன்படுத்தின. Bahdanau, Kyunghyun Cho, Bengio ஆகியோர் 2014 இல் குறிப்பாகச் செல்வாக்குள்ள attention-based மொழிபெயர்ப்பு model ஐ அறிமுகப்படுத்தினர்; ஒரே நிலையான அளவுச் சுருக்கத்தைச் சார்ந்திராமல், decoder தொடர்புடைய மூலத் தகவலைத் தெரிவுசெய்ய இது அனுமதித்தது. ஆகவே attention, Transformer க்கு முந்தையது.
Cho உம் சகாக்களும் 2014 இல் செய்த encoder-decoder வேலையில் அறிமுகமான Gated recurrent units (GRUs), மற்றொரு முக்கிய gated recurrent வடிவமைப்பைத் தந்தன. Reset, update gates, முந்தைய state உம் புதிய உள்ளீடும் அடுத்த state க்கு எப்படிப் பங்களிக்கின்றன என்பதைக் கட்டுப்படுத்துகின்றன. GRU கள் பொதுவாக நிலையான LSTM களை விட எளிய state கட்டமைப்பைப் பயன்படுத்துகின்றன; ஆனால் பணிகள், பயிற்சி நிலைமைகள் முழுவதும் எந்தக் கட்டமைப்பும் உலகளாவிய ரீதியில் உயர்ந்ததல்ல.
Generative modelling
Diederik Kingma உம் Max Welling உம் 2013–2014 இல் செய்த செல்வாக்குள்ள வேலையில் அறிமுகமான Variational autoencoders, latent-variable மாதிரியாக்கத்தைத் திறமையான gradient-based பயிற்சியுடன் இணைத்தன. 2014 இல் Ian Goodfellow உம் சகாக்களும் அறிமுகப்படுத்திய Generative adversarial networks, ஒரு generator ஐ discriminator க்கு எதிராகப் பயிற்றுவித்தன. இரண்டும் generative modelling இன் முக்கிய இழைகளாகின; நவீன உள்ளடக்க உருவாக்கத்தை மையமாகக் கொண்ட வரலாற்றில் இரண்டையும் விட்டுவிடக் கூடாது.
Optimisation மேலும் நம்பகமாகிறது
Adam, ஒவ்வொரு parameter க்குமான adaptive learning rates ஐ momentum போன்ற மதிப்பீடுகளுடன் இணைத்தது. Batch normalisation, பயிற்சியின்போது இடைநிலை activations ஐ மாற்றி, பல கட்டமைப்புகளில் பயனுள்ளதாக நிரூபணமானது. மேம்பட்ட initialisation, residual பாதைகள், normalisation ஆகியவை சேர்ந்து நடைமுறைப் பயிற்சித் தடைகளைக் குறைத்தன.
Highway Networks உம், மிக ஆழமான networks ஐப் பயிற்றுவிக்க gated பாதைகளை ஆராய்ந்தன; இது skip connections பரவலாகப் பயன்படுத்தப்படுவதற்கான முக்கிய இணை முன்னோடி. (Highway Networks, 2015.)
Deep reinforcement learning
Deep Q-networks, reward சமிக்ஞைகள், experience replay, நிலைப்படுத்தும் வழிமுறைகளைப் பயன்படுத்தி, pixels இலிருந்து விளையாட்டுக் கொள்கைகளைக் கற்க முடியும் என்று காட்டின. AlphaGo, neural networks, reinforcement learning, search ஆகியவற்றை இணைத்து, Go இல் மைல்கல் செயல்திறனை அடைந்தது. கணிப்பு, செயல், search ஆகியவை சேர்ந்து செயல்பட முடியும் என்பதை இந்த அமைப்புகள் காட்டுகின்றன; இவை வெறும் text generators அல்ல. (DQN, 2015; AlphaGo, 2016.)
9. 2017: Transformer
Ashish Vaswani உம் ஏழு இணை ஆசிரியர்களும் “Attention Is All You Need” இல் Transformer ஐ அறிமுகப்படுத்தினர். அதன் அசல் encoder-decoder வடிவமைப்பு, தொடர்வரிசைச் செயலாக்கத்துக்கு recurrence க்குப் பதிலாக attention ஐப் பயன்படுத்தி, பயிற்சியின்போது இணைச்செயலாக்கத்தை மேம்படுத்தியது. அந்தக் கட்டுரை முதலில் மொழிபெயர்ப்பைப் பற்றியது; உலகளாவிய chatbot பற்றியது அல்ல.
Attention கணிப்பு
token representations இன் matrix X கொடுக்கப்பட்டால், கற்ற projections queries, keys, values ஐ உருவாக்குகின்றன:
Q = XWQ; K = XWK; V = XWVAttention(Q, K, V) = softmax(QKᵀ / √dₖ)VQueries உம் keys உம் இணக்கப் புள்ளிகளைத் தீர்மானிக்கின்றன. Scaling அவற்றின் எண் அளவைக் கட்டுப்படுத்த உதவுகிறது. Softmax அனுமதிக்கப்பட்ட நிலைகள் மீது normalise செய்யப்பட்ட weights ஐ உருவாக்குகிறது. V ஆல் பெருக்குவது value vectors ஐ இணைக்கிறது. இந்த weights ஒரு model இன் காரணப்படுத்தலுக்கான உத்தரவாதமான விளக்கங்களோ, ஒரு கூற்று உண்மை என்பதற்கான நேரடி நிகழ்தகவுகளோ அல்ல.
Multi-head attention
பல கற்ற projections, பல attention கணிப்புகளை உருவாக்குகின்றன. அவற்றின் வெளியீடுகள் இணைக்கப்பட்டு (concatenate), மற்றொரு கற்ற projection ஆல் கலக்கப்படுகின்றன. 512-பரிமாண representation உம் எட்டு சம அளவு heads உம் இருந்தால், ஒவ்வொரு head உம் 64 பரிமாணங்களைப் பயன்படுத்தலாம்; ஆனால் projections முழு உள்ளீட்டு representation இலிருந்தும் எடுக்க முடியும். இது embedding ஐ எட்டு நிலையான பொருள்சார் துண்டுகளாக வெட்டுவது மட்டுமல்ல. ஒரு head பயனுள்ள வடிவத்தைக் கற்கலாம்; “grammar”, “tone”, “pronoun” போன்ற உத்தரவாதமான வேலை அதற்கு ஒதுக்கப்படுவதில்லை.
நிலையும் காரணத் தொடர்ச்சியும் (causality)
Attention மட்டும் சாதாரணத் தொடர்வரிசை ஒழுங்கை வழங்குவதில்லை. Positional encodings அல்லது பிற நிலை வழிமுறைகள் அந்தத் தகவலைத் தருகின்றன. ஒரு causal language model பயிற்சியின்போது எதிர்கால நிலைகளை mask செய்கிறது. பயிற்சி பல நிலைகளை இணையாகச் செயலாக்கலாம்; ஆனால் சாதாரண autoregressive உருவாக்கம் இன்னும் புதிய tokens ஐ வரிசையாகவே உருவாக்குகிறது. ஆகவே “Transformers எல்லாவற்றையும் ஒரே நேரத்தில் செயலாக்குகின்றன” என்பது முழுமையற்ற விளக்கம்.
சிக்கலளவு (Complexity)
நிலையான dense attention நிலைகளின் சோடிகளை ஒப்பிடுகிறது; இது தொடர்வரிசை நீளத்தில் quadratic attention வேலையைத் தருகிறது. அது முக்கிய bottleneck; ஆனால் Transformer இன் ஒவ்வொரு பகுதியும் quadratic அல்ல; புதிய kernels உம் கட்டமைப்புகளும் நினைவக நடத்தையை மாற்றுகின்றன. Optimisation பற்றி உண்மையான algorithm, தொடர்வரிசை நீளம், வன்பொருள், வேலைச்சுமி அடிப்படையில் பேச வேண்டும்.
10. Pretraining உம் foundation models உம்: 2018–2022
BERT, மொழிப் புரிதலுக்கான bidirectional masked-language pretraining ஐப் பிரபலப்படுத்தியது. GPT-பாணி அமைப்புகள் autoregressive pretraining, transfer ஐ வளர்த்தன; GPT-3 கணிசமாக அதிகரித்த அளவில் வலுவான in-context few-shot செயல்திறனைக் காட்டியது. In-context learning, prompt இல் உள்ள எடுத்துக்காட்டுகளைப் பயன்படுத்துகிறது; அது model இன் weights ஐப் புதுப்பிப்பதற்குச் சமமல்ல.
Scaling ஆய்வு, parameter எண்ணிக்கை, தரவு, கணிப்பீட்டுடன் செயல்திறன் எப்படி மாறுகிறது என்பதை ஆராய்ந்தது. Chinchilla பின்னர், ஒரு compute budget இன் கீழ் model அளவையும் பயிற்சித் தரவையும் சமநிலைப்படுத்துவதை வலியுறுத்தியது. தரவு, compute ஒதுக்கீடு அல்லது மதிப்பீடு மோசமாக இருந்தால், பெரியது என்பது தானாகச் சிறந்தது அல்ல.
Foundation model என்ற சொல், பல downstream பணிகளுக்கு ஏற்றவாறு மாற்றியமைக்கக்கூடிய, பரந்த அளவில் முன்பயிற்றுவிக்கப்பட்ட model ஐ விவரிக்கிறது. அந்த model எல்லாவற்றையும் அறியும், உலகளாவிய ரீதியில் நம்பகமானது அல்லது ஒரு குறிப்பிட்ட கட்டமைப்பையே பயன்படுத்தும் என்பதை அது குறிக்காது.
InstructGPT, supervised fine-tuning உம் மனிதக் கருத்துக்களிலிருந்து reinforcement learning உம் கொண்ட pipeline ஐக் காட்டியது. 2022 நவம்பரில் ChatGPT இன் பொது வெளியீடு, உரையாடல் தொடர்பாடலை மிகப் பரந்த பார்வையாளர்களுக்குக் கொண்டுவந்தது. ஆய்வு வளர்ச்சியும் product வெளியீடும் வெவ்வேறு மைல்கற்கள்.
Self-supervised learning மொழிக்கு அப்பாலும் செழித்தது. SimCLR போன்ற contrastive முறைகள், தரவின் வெவ்வேறு காட்சிகளைத் தொடர்புபடுத்தி பயனுள்ள காட்சி representations ஐக் கற்று, representation கற்றலுக்கு மனித labels மீதான சார்பைக் குறைத்தன. பயிற்சி objective க்கும் தரவு மாற்றங்களுக்கும் உள்ள தொடர்பு, எதைக் கற்கிறது என்பதன் மையம்.
11. AlexNet க்குப் பின் பார்வை: திறன், Transformers, segmentation
- MobileNet, 2017: depthwise separable convolutions திறமையான மொபைல் பார்வைக்கு ஆதரவளித்தன.
- EfficientNet, 2019: compound scaling, network ஆழம், அகலம், பட resolution ஐச் சமநிலைப்படுத்தியது.
- Vision Transformer, 2020 preprint: படங்கள் patches இன் தொடர்வரிசைகளாயின; பெரிய அளவு pretraining க்குப் பின் வலுவான முடிவுகள் கிடைத்தன.
- CLIP, 2021: contrastive பயிற்சி படங்களையும் மொழியையும் இணைத்து, text விளக்கங்கள் மூலம் transfer ஐ இயலச் செய்தது.
- ConvNeXt, 2022: ஒரு convolutional network ஐ நவீனப்படுத்துவது, CNN கள் போட்டித்தன்மையுடன் இருப்பதைக் காட்டியது. Transformers convolution ஐ வழக்கொழிக்கவில்லை.
- Segment Anything, 2023, SAM 2, 2024: promptable segmentation பொது நோக்கக் காட்சிக் கருவிகளை முன்னேற்றியது; SAM 2 இந்தத் திசையைப் படங்கள், வீடியோவுக்கு விரிவாக்கியது. இவை segmentation அமைப்புகள்; முழுமையான reasoning உதவியாளர்கள் அல்ல.
CNN கள் பயனுள்ள உள்ளூர் கட்டமைப்பையும் weight sharing ஐயும் தருகின்றன. ViT கள் பட tokens இடையே நெகிழ்வான இடைவினைகளைத் தருகின்றன. திறனிலோ தரத்திலோ எதற்கும் உலகளாவிய ஏகபோகம் இல்லை: தரவு, pretraining, கட்டமைப்பு, deployment கட்டுப்பாடுகள் முடிவைத் தீர்மானிக்கின்றன.
12. Diffusion, flow matching, multimodal AI
Diffusion அடிப்படையிலான generative modelling க்கு அண்மைய பிரபலத்துக்கு முன்பே வேர்கள் உண்டு. 2020 denoising diffusion வேலை உயர்தரப் பட உருவாக்கத்தைக் காட்ட உதவியது. Latent diffusion, கற்ற சுருக்கப்பட்ட representation இல் இயங்கிச் செலவைக் குறைத்தது. Flow-matching ஆய்வு, எளிய distributions க்கும் தரவுக்கும் இடையிலான மாற்றங்களைக் கற்க தொடர்புடைய வழிகளை உருவாக்கியது. இவை தொடர்புடைய ஆய்வுக் குடும்பங்கள்; ஒரே algorithm க்கான மாற்றிக்கொள்ளக்கூடிய பெயர்கள் அல்ல. (Diffusion, 2015; DDPM, 2020; Latent diffusion; Flow matching.)
Multimodal அமைப்புகள் text, படங்கள், ஒலி, வீடியோ அல்லது பிற சமிக்ஞைகளை இணைக்கின்றன. சில, ஏற்கனவே உள்ள language model உடன் ஒரு vision encoder ஐ இணைக்கின்றன; மற்றவை மேலும் ஒருங்கிணைந்த முறையில் பயிற்றுவிக்கப்படுகின்றன. படங்கள் patches ஆகவும், ஒலி கற்ற அம்சங்கள் அல்லது codec tokens ஆகவும், வீடியோ இடம்-காலப் representations ஆகவும் குறிக்கப்படலாம். ஒவ்வொரு அமைப்பும் ஒவ்வொரு modality ஐயும் தனித்த குறியீடுகளாக tokenise செய்வதில்லை; சரியாக ஒரே செயலாக்கப் பாதையையும் பகிர்வதில்லை. (Flamingo; Gemini technical report.)
ஒரு model பல உள்ளீட்டு வகைகளைப் புரிந்துகொண்டாலும் அவை அனைத்தையும் உருவாக்க வேண்டியதில்லை. “any-to-any” இடைமுகம் ஒரு அமைப்புத் திறன்; ஒரே உலகளாவிய உள் வடிவமைப்புக்கான சான்று அல்ல. Multimodality கிடைக்கும் தகவலை விரிவாக்குகிறது; ஆனால் ஒத்திசைவு, தரவுத் தரம், மதிப்பீடு, பாதுகாப்புச் சவால்களையும் அறிமுகப்படுத்துகிறது.
13. Dense attention க்கு அப்பால்: recurrence, state spaces, hybrids
State-space sequence models, இயக்கவியல் அமைப்புகள், கட்டுப்பாட்டுக் கோட்பாட்டின் கருத்துக்களைக் கற்ற தொடர்வரிசைச் செயலாக்கத்துடன் இணைக்கின்றன. S4, நீண்ட தொடர்வரிசைகளுக்கான கட்டமைக்கப்பட்ட state-space அணுகுமுறைகளை நிறுவ உதவியது. Mamba, உள்ளீட்டைச் சார்ந்த தெரிவையும் வன்பொருள் அறிந்த செயலாக்கத்தையும் அறிமுகப்படுத்தியது. RWKV, பயிற்சி இணைச்செயலாக்கமும் recurrent inference உம் கொண்ட வேறு recurrent language-modelling வழியை ஆராய்ந்தது. (S4; Mamba; RWKV.)
உள்ளுணர்வுக்கு: state-space recurrence ஒரு மறைந்த state ஐ தற்போதைய உள்ளீடு, முந்தைய state ஐப் பயன்படுத்திப் புதுப்பிக்கிறது. Mamba, அதன் step-size, உள்ளீடு/வெளியீடு தொடர்பான parameters உட்பட தெரிவுசெய்த அளவுகளை உள்ளீட்டைச் சார்ந்தவையாக்குகிறது. எதைத் தக்கவைப்பது அல்லது அடக்குவது என்பதை model கற்க இது உதவுகிறது. பெரிய step-size என்பது உலகளாவிய ரீதியில் சரியான “முக்கிய உண்மை” கண்டறிவி அல்ல; முழுமையான கற்ற இயக்கவியலே அதன் விளைவைத் தீர்மானிக்கிறது.
நிலையான அளவு recurrent state, decoding-state நினைவகத்தை முந்தைய tokens இன் எண்ணிக்கையிலிருந்து சுயாதீனமாக்கலாம். ஆனால் அது weights, பயிற்சி activations, முழு runtime அல்லது மொத்தச் செயலாக்க நேரத்தை மாறிலியாக்குவதில்லை. வரலாற்றைச் சுருக்குவதும் சமரசங்களை உருவாக்குகிறது: வரையறுக்கப்பட்ட state தன்னிச்சையான வரலாறுகளை இழப்பின்றிப் பாதுகாக்க முடியாது.
Hybrid அமைப்புகள் recurrent/state-space layers ஐ attention உடன் இணைக்கின்றன. Jamba, Zamba, Nemotron-H வெவ்வேறு சேர்க்கைகளைக் காட்டுகின்றன. விகிதங்களும் layer வடிவமைப்புகளும் மாறுபடும்; ஒவ்வொரு ஏழு Mamba layers க்குப் பின்னும் ஒரு attention layer ஐ hybrid பயன்படுத்த வேண்டும் என்ற உலகளாவிய விதி இல்லை. Attention மீட்டெடுப்புக்கு உதவலாம்; ஆனால் தூய Transformers உம் hybrids உம் முழுமையான நினைவுகூரலுக்கு உத்தரவாதம் தருவதில்லை.
இந்த வளர்ச்சிகள் Transformers க்கு மாற்றுகளும் நிரப்புகளும்; ஒரு கட்டமைப்பு மற்றவை அனைத்தையும் நிரந்தரமாக இடம்பெயர்த்துவிட்டது என்பதற்கான சான்று அல்ல.
14. நினைவகப் பிரச்சினை: KV caches உம் திறமையான serving உம்
Autoregressive decoding இன்போது, Transformer முந்தைய key, value vectors ஐ cache செய்து, மீளக் கணக்கிடத் தேவையின்றிச் செய்யலாம். இது உருவாக்கத்தை விரைவுபடுத்துகிறது; ஆனால் context உடனும் batch அளவுடனும் பொதுவாக வளரும் நினைவகத்தை எடுத்துக்கொள்கிறது.
வெவ்வேறு நுட்பங்கள் வெவ்வேறு செலவுகளைக் குறிவைக்கின்றன:
- Multi-query attention, grouped-query attention: query heads இடையே key/value heads ஐப் பகிர்ந்து, cache அகலத்தைக் குறைக்கின்றன. (MQA; GQA.)
- Multi-head latent attention: keys, values இன் சுருக்கப்பட்ட latent representations ஐப் பயன்படுத்துகிறது; DeepSeek-V2 ஒரு முக்கிய எடுத்துக்காட்டு.
- Sliding-window அல்லது sparse attention: எந்த நிலைகள் எவற்றைக் கவனிக்கலாம் என்பதைக் கட்டுப்படுத்துகிறது. சில models உள்ளூர், உலகளாவிய layers ஐ இணைக்கின்றன. உள்ளூர் window பழைய tokens க்கான நேரடி அணுகலை இழக்கலாம்.
- KV-cache quantisation, eviction: எண் துல்லியத்தைக் குறைக்கின்றன அல்லது தெரிவுசெய்த சேமித்த பதிவுகளை நீக்குகின்றன; துல்லியச் சமரசங்களுடன்.
- FlashAttention: துல்லியமான attention எப்படிக் கணக்கிடப்பட்டு நினைவகத்தினூடாக நகர்த்தப்படுகிறது என்பதை மாற்றுகிறது; dense attention ஐக் கணிதரீதியாக linear-time ஆக்குவதில்லை.
- PagedAttention: serving அமைப்புகளில் cache நினைவகத்தின் ஒதுக்கீட்டையும் பகிர்வையும் மேம்படுத்துகிறது. ஒவ்வொரு எண்ணையும் சுருக்குவதை விட, சிதறலை (fragmentation) எதிர்கொள்கிறது.
“தரம் இழப்பின்றி 90% குறைவான நினைவகம்” போன்ற கூற்றுகளுக்குச் சரியான model, baseline, அளவீட்டு நிலைமைகள் தேவை. அவற்றை ஒவ்வொரு deployment க்கும் பொதுமைப்படுத்தக் கூடாது.
15. Mixture-of-Experts: தெரிவுசெய்த கணிப்புடன் அதிக ஆற்றல்
Mixture-of-Experts க்கு 1990 களின் தொடக்கத்தில் adaptive mixtures பற்றிய வேலையில் வேர்கள் உண்டு. நவீன sparsely gated MoE layers, ஒவ்வொரு உள்ளீடு அல்லது token க்கும் expert networks இன் ஒரு உட்தொகுப்பைத் தெரிவுசெய்ய கற்ற router ஐப் பயன்படுத்துகின்றன. இது ஒவ்வொரு token இலும் ஒவ்வொரு parameter ஐயும் செயல்படுத்தாமல் மொத்த parameter ஆற்றலை அதிகரிக்க முடியும். (Jacobs and colleagues, 1991; Shazeer and colleagues, 2017.)
Experts என்பவை கற்ற subnetworks; “இயற்பியல்”, “சட்டம்”, “coding” போன்ற வெளிப்படையான துறைகள் அவசியம் அல்ல. Routing சமநிலையற்ற வேலைச்சுமை, தொடர்பாடல் மேலதிகச் சுமை, பயிற்சி நிலையின்மையை உருவாக்கலாம். செயலில் உள்ள parameter எண்ணிக்கை சிறிதாக இருந்தாலும் மொத்த model நினைவகமும் network போக்குவரத்தும் முக்கியமாகவே இருக்கும். MoE என்பது கூடுதல் செலவின்றி வரம்பற்ற அறிவு என்று பொருள்படாது.
16. Post-training, reasoning, test-time கணிப்பீடு
SFT, RLHF, DPO, Constitutional AI
மனிதக் கருத்துக்களிலிருந்து கற்றல் ChatGPT க்கும் நவீன language-model alignment க்கும் முந்தையது. 2017 இல் Paul Christiano, Jan Leike, இணை ஆய்வாளர்கள், விளையாட்டு, உருவகப்படுத்தப்பட்ட இயக்கப் பணிகள் உட்பட, குறுகிய நடத்தைத் துண்டுகள் மீதான மனிதத் தெரிவுகளிலிருந்து deep reinforcement learning ஐக் காட்டினர். இது language models க்கான பிற்கால reward-modelling pipelines இன் செல்வாக்குள்ள முன்னோடி; machine learning இல் மனிதர்களின் கருத்தைப் பயன்படுத்திய முதல் தடவை அல்ல. (Deep reinforcement learning from human preferences.)
Supervised fine-tuning செய்துகாட்டல்களிலிருந்து கற்பிக்கிறது. RLHF, மனிதக் கருத்தை, பெரும்பாலும் விருப்ப ஒப்பீடுகளை, பயன்படுத்தி reward அடிப்படையிலான செயல்முறை மூலம் நடத்தையை வடிவமைக்கிறது. DPO, வழக்கமான தனி reward-model-and-online-RL pipeline இல்லாமல், தெரிவுசெய்த/நிராகரித்த பதில் சோடிகளிலிருந்து optimise செய்ய ஒரு வழியைத் தருகிறது. Constitutional AI, எழுதப்பட்ட கொள்கைகளையும் AI கருத்தையும் பயிற்சியின் பகுதியாகப் பயன்படுத்துகிறது. இவற்றில் எதுவும் உண்மைத்தன்மை, தீங்கின்மை அல்லது உலகளாவிய alignment க்கு உத்தரவாதம் அல்ல. (InstructGPT; DPO; Constitutional AI.)
Deliberative alignment என்பது, பதிலளிக்கும்போது பாதுகாப்பு விவரக்குறிப்புகளைப் பயன்படுத்த reasoning models ஐப் பயிற்றுவிக்கும் பிற்கால அணுகுமுறை. இது முன்மொழியப்பட்ட ஒரு பயிற்சி உத்தி; எல்லா models உம் உள்ளே அதே முறையைப் பின்பற்றுகின்றன என்பதற்கான சான்று அல்ல.
Test-time கணிப்பீடு
ஒரு பிரச்சினையைப் பெற்ற பின் ஒரு அமைப்பு அதிகக் கணிப்பீட்டைச் செலவிடலாம்: நீண்ட candidate தீர்வுகளை உருவாக்குதல், மாற்றுகளை மாதிரியெடுத்தல், search ஐப் பயன்படுத்துதல், tools ஐ அழைத்தல், இடைநிலை முடிவுகளைச் சரிபார்த்தல். அதிகக் கணிப்பீடு சில விளைவுகளை மேம்படுத்தலாம்; ஆனால் பிழைகளைப் பெருக்கவோ வளங்களை வீணாக்கவோ கூடும். வெளிப்படையான விளக்கங்கள் ஒவ்வொரு உள் கணிப்பின் உண்மையான பதிவுகளாக இருக்க வேண்டியதில்லை.
GRPO உம் DeepSeek-R1 உம்
Group Relative Policy Optimisation 2024 இல் DeepSeekMath இல் அறிமுகமானது. அது மாதிரியெடுத்த வெளியீடுகளின் ஒரு குழு முழுவதும் rewards ஐ ஒப்பிடுகிறது; அந்த வடிவமைப்பில் தனியான கற்ற value model ஐத் தவிர்க்கிறது. இது சில PPO அமைப்புகளோடு ஒப்பிடும்போது நினைவகத்தைக் குறைக்கலாம்; மொத்தப் பயிற்சிச் செலவில் உலகளாவிய 50% குறைப்பைக் குறிக்காது. (DeepSeekMath.)
DeepSeek-R1 இன் 2025 அறிக்கை, R1-Zero உம் மேலும் விரிவான R1 pipeline உம் உட்பட, reasoning க்கான reinforcement learning ஐ ஆராய்ந்தது. Distilled models பயனுள்ள நடத்தையை சிறிய models க்கு மாற்றின. அறிக்கையின் ஏறத்தாழ 800,000 தொகுக்கப்பட்ட எடுத்துக்காட்டுகள் reasoning, non-reasoning தரவு இரண்டையும் கொண்டிருந்தன; 800,000 முழுமையாகச் சரிபார்க்கப்பட்ட reasoning traces அல்ல. (DeepSeek-R1.)
Distillation உம் process rewards உம்
Distillation, நிகழ்தகவுகள், பதில்கள், தீர்வு traces போன்ற ஒரு ஆசிரியர் (teacher) இடமிருந்து வரும் தகவலைப் பயன்படுத்தி ஒரு மாணவரை (student) பயிற்றுவிக்கிறது. அது reasoning models க்கு முந்தையது. சிறிய model பயனுள்ள திறன்களைப் பெறலாம்; ஆனால் முடிவுகள் student, பணி, தரவைப் பொறுத்தவை; அது ஒருபோதும் தன் teacher ஐ மிஞ்ச முடியாது என்ற உலகளாவிய கூற்று மிகையானது. (Hinton, Vinyals and Dean, 2015.)
Process reward models இடைநிலைப் படிகளுக்குப் புள்ளியிடுகின்றன; outcome supervision இறுதி முடிவுகளுக்குப் புள்ளியிடுகிறது. படி-நிலைக் கருத்து search ஐயும் கற்றலையும் மேம்படுத்தலாம்; ஆனால் செலவானது; அதுவே தவறாகவோ ஏமாற்றப்படக்கூடியதாகவோ இருக்கலாம். இறுதி விடையைச் சரிபார்க்கும் verifier, ஒவ்வொரு இடைநிலை விளக்கமும் சரியானது என்பதை நிரூபிப்பதில்லை. (Let's Verify Step by Step.)
17. Synthetic data, retrieval, agents
Synthetic data, அறிவுறுத்தல் எடுத்துக்காட்டுகள், code, கணிதப் பணிகள், உருவகப்படுத்தப்பட்ட அனுபவங்கள், teacher உருவாக்கிய தீர்வுகளை வழங்கலாம். தரம் செயல்முறையின் வடிவமைப்பிலிருந்து வருகிறது; இயந்திரத்தால் உருவாக்கப்பட்டது என்பதால் மட்டும் அல்ல. Execution சோதனைகள் சோதித்த சந்தர்ப்பங்களில் குறிப்பிட்ட நடத்தையைச் சரிபார்க்கின்றன; ஒரு program ஒவ்வொரு சூழ்நிலையிலும் சரியானது என்பதற்கு உத்தரவாதம் தருவதில்லை.
Filtering, பன்முகத்தன்மைச் சோதனைகள், மூலத் தடம் (provenance), contamination சோதனைகள், சுயாதீன மதிப்பீடு ஆகியவை அவசியம். மோசமாகக் கட்டுப்படுத்தப்பட்ட உருவாக்கத் தரவில் மீண்டும் மீண்டும் பயிற்சி அளிப்பது distributions ஐச் சிதைக்கலாம்; ஆனால் “எல்லா synthetic data உம் தவிர்க்க முடியாமல் collapse ஐ ஏற்படுத்தும்” என்பதும் மிகைக் கூற்று. (Self-Instruct; Model-collapse ஆய்வு.)
Retrieval-augmented generation பதிலளிக்கும் நேரத்தில் வெளிப் பொருளை வழங்குகிறது. அது grounding ஐ மேம்படுத்தி, மீளப் பயிற்றுவிக்காமல் அறிவைப் புதுப்பிப்பதை எளிதாக்கலாம். Retrieval இன்னும் தொடர்புடைய சான்றைத் தவறவிடலாம், தவறான உள்ளடக்கத்தை மீட்கலாம் அல்லது generator ஆல் புறக்கணிக்கப்படலாம். (RAG paper.)
Agentic அமைப்புகள் ஒரு model ஐ observe–plan–act–check loop இல் வைக்கின்றன. Tools இல் search, code execution, databases, application APIs அடங்கலாம். Memory context இல், கட்டமைக்கப்பட்ட குறிப்புகளில், retrieval stores இல் வைக்கப்படலாம். Multi-agent வடிவமைப்புகள் வேலையைப் பிரிக்கின்றன; ஆனால் கூடுதல் agents தானாக நம்பகத்தன்மையை மேம்படுத்துவதில்லை. (ReAct.)
பொறியியல் சவால் language modelling ஐ விடப் பரந்தது: குறைந்தபட்ச அணுகல் (least-privilege), தெளிவான அனுமதிகள், sandboxing, validation, audit logs, budgets, மீட்கக்கூடிய தன்மை, மனிதக் கண்காணிப்பு ஆகியவை ஒரு agent பாதுகாப்பாகச் செயல்பட முடியுமா என்பதைத் தீர்மானிக்கின்றன. MCP போன்ற tools ஐ இணைக்கும் protocol ஒரு உள்கட்டமைப்பு; neural கட்டமைப்போ நம்பகமான நடத்தைக்கான உத்தரவாதமோ அல்ல.
18. Models ஐப் புரிந்துகொள்ளுதல்: mechanistic interpretability
Mechanistic interpretability, வெளியீடுகளை மட்டும் மதிப்பிடாமல் உள் கணிப்புகளை ஆராய்கிறது. ஆய்வாளர்கள் features, circuits, attention heads, தலையீடுகளின் காரண விளைவுகளை ஆராய்கின்றனர்.
ஒரு தனி neuron தொடர்பற்ற பல வடிவங்களுக்குப் பதிலளிக்கலாம். Sparse autoencoders, activations ஐ அரிதாகப் பயன்படும் பெரிய features தொகுப்பாகப் பிரிக்க முயல்கின்றன. இது பயனுள்ள விளக்கக்கூடிய features ஐ உருவாக்கியுள்ளது; ஆனால் ஒவ்வொரு feature உம் ஒரு தெளிவான கருத்தாக இருக்கும் குறைபாடற்ற அகராதியை அல்ல. (Towards Monosemanticity; Scaling Monosemanticity.)
Circuit tracing உம் feature தலையீடுகளும் வழிமுறைகளை வெளிப்படுத்தலாம்; சில நேரங்களில் நடத்தையைத் திசைதிருப்பலாம். அவை இன்னும் ஒரு frontier model இன் முழுமையான தணிக்கையையோ உத்தரவாதமான “நேர்மை switch” ஐயோ தருவதில்லை. காட்டப்படும் reasoning trace உம் network இன் காரண விளக்கமும் வெவ்வேறு வகைச் சான்றுகள்.
19. ரோபோட்டிக்ஸ் உம் world models உம்
Vision-Language-Action அமைப்புகள்
Vision-Language-Action models புலனுணர்வையும் மொழியையும் ரோபோ செயலுடன் இணைக்கின்றன. RT-2, vision-language pretraining இலிருந்து action representations க்கான ஒரு வழியைக் காட்டியது; diffusion policies உம் flow-based policies உம் தொடர்ச்சியான செயல் தொடர்வரிசைகளை உருவாக்க வழிகளைத் தருகின்றன. வெவ்வேறு அமைப்புகள் வெவ்வேறு control அதிர்வெண்கள், action spaces, பாதுகாப்பு layers ஐப் பயன்படுத்துகின்றன. (RT-2; Diffusion Policy; π0.)
Teleoperation உம் simulation உம் பயிற்சி அனுபவங்களைச் சேகரிக்க உதவுகின்றன; ஆனால் உண்மைச் சூழல்களுக்கு மாற்றுவது இன்னும் கடினம். பௌதிக இடைவினை, text கணிப்பு கொண்டிராத கட்டுப்பாடுகளைக் கொண்டுவருகிறது: latency, தொடு இயக்கவியல், sensor பிழைகள், வன்பொருள் சேதம், மனிதப் பாதுகாப்பு. ஒரு வெற்றிகரமான செய்முறை விளக்கம், தன்னிச்சையான வீடுகளிலோ தொழிற்சாலைகளிலோ பொது நோக்கத் தன்னாட்சிக்கான சான்று அல்ல.
2025 இல் அறிமுகமான Figure இன் Helix, உயர்மட்டக் காட்சி-மொழிச் செயலாக்கத்தை வேகமான மோட்டார் கட்டுப்பாட்டுடன் இணைக்கும், VLA அமைப்புக்கான மற்றொரு எடுத்துக்காட்டு. இத்தகைய multi-rate வடிவமைப்புகள் மெதுவான திட்டமிடலை விரைவான செயலிலிருந்து பிரிக்கின்றன; ஆனால் அதிர்வெண்களும் திறன்களும் அந்தந்த அமைப்புக்கே உரியவை.
World models
World models ஒரு சூழல் எப்படி மாறுகிறது என்பதன் representations ஐக் கற்கின்றன; செயல்களைச் சார்ந்ததாகவும் இருக்கலாம். அவை திட்டமிடலுக்கோ policy பயிற்சிக்கோ ஆதரவளிக்கலாம். நவீன எடுத்துக்காட்டுகள் முந்தைய model-based reinforcement learning ஐ latent கணிப்பு, generative சூழல்களுடன் இணைக்கின்றன. (World Models, 2018; DreamerV3.)
JEPA பாணி வேலை, ஒவ்வொரு pixel ஐயும் மீளுருவாக்கத் தேவைப்படுத்தாமல் representations ஐக் கணிக்கிறது. Genie கற்ற ஊடாடும் சூழல்களை ஆராய்கிறது. இந்த அமைப்புகள் பயனுள்ள ஒழுங்குகளைப் பிடிக்கலாம்; ஆனால் யதார்த்தமாகத் தோன்றும் வீடியோ சரியான இயற்பியல், காரணப் புரிதல் அல்லது பாதுகாப்பான கட்டுப்பாட்டுக்கான சான்று அல்ல. (I-JEPA; Genie.)
World Labs இன் Marble, multimodal உள்ளீடுகளிலிருந்து ஆராயக்கூடிய 3D சூழல்களை உருவாக்கும், இடஞ்சார் உருவாக்கத்துக்கான மற்றொரு எடுத்துக்காட்டைச் சேர்க்கிறது. ஒரு இடஞ்சார் காட்சியை உருவாக்குவதும், பௌதிகரீதியாகச் செல்லுபடியாகும், செயல்-சார் simulator ஐக் கற்பதும் தொடர்புடைய இலட்சியங்கள்; ஒரே சாதனைகள் அல்ல.
20. Models க்குப் பின்னால் உள்ள வன்பொருளும் உள்கட்டமைப்பும்
நவீனக் கதை GPU கள், TPU கள், மொபைல் neural processing units (NPUs), பிற accelerators; அதிக-அலைவரிசை நினைவகம்; அதிவேக interconnects; mixed-precision எண்கணிதம்; distributed மென்பொருள்; தரவு மையங்களின் மின்சாரம், குளிரூட்டல் ஆகியவற்றிலிருந்து பிரிக்க முடியாதது.
NVIDIA இன் CUDA சூழல் அமைப்பு GPU கணிப்பை அணுகக்கூடியதாகவும் பயனுள்ளதாகவும் ஆக்குவதில் முக்கியமானது. எல்லா AI உம் NVIDIA ஐப் பயன்படுத்த வேண்டும் எனக் கூறாமல் அந்தப் பங்களிப்பை அங்கீகரிக்க வேண்டும். Google இன் TPU, சிறப்பு neural-network வன்பொருளுக்கான முக்கிய மாற்று எடுத்துக்காட்டு. (CUDA ஆவணம்; TPU கட்டமைப்புக் கட்டுரை.)
பயிற்சிக்கும் inference க்கும் வெவ்வேறு bottlenecks உண்டு. சிறிய-batch decoding க்கு நினைவக அலைவரிசை பெரும்பாலும் முக்கியம்; மற்ற வேலைச்சுமிகளில் compute பயன்பாடும் தொடர்பாடலும் ஆதிக்கம் செலுத்தலாம். Data, tensor, pipeline, expert parallelism வேலையின் வெவ்வேறு பகுதிகளைப் பகிர்கின்றன. Rack-அளவு interconnect தொடர்பாடலை உடனடியாக்குவதில்லை; தனித்தனிச் சாதனங்களுக்கு இடையிலான வேறுபாட்டையும் அழிப்பதில்லை.
Blackwell, Rubin, Trillium, Ironwood போன்ற வன்பொருள் தலைமுறைகள் இந்த உள்கட்டமைப்புக் கதையில் இடம்பெறுகின்றன; ஆனால் அவற்றின் எண் விவரக்குறிப்புகள், கிடைக்கும் தன்மை, ஆதரிக்கப்படும் precision வடிவங்கள் ஒவ்வொரு product க்கும் சரிபார்க்கப்பட வேண்டும். எந்த ஒரு அலைவரிசை, rack மின்சாரம், cluster அளவு எண்ணும் முழுத் துறையையும் விவரிப்பதில்லை. சக்தி ஒப்பீடுகள் ஒரு chip இன் விளம்பரப்படுத்திய உச்ச எண்கணிதத் திறனை மட்டுமன்றி, முழு அமைப்பையும் வேலைச்சுமியையும் கருத்தில் கொள்ள வேண்டும்.
மென்பொருள் frameworks, ஆய்வை பரவலாகப் பயன்படுத்தக்கூடிய பொறியியல் துறையாக மாற்ற உதவின. 2015 இல் TensorFlow இன் பொது வெளியீடும் PyTorch இன் பிற்கால imperative நிரலாக்க அணுகுமுறையும் automatic differentiation, accelerator பயன்பாடு, model பரிசோதனையை மேலும் அணுகக்கூடியதாக்கின. Frameworks அடிப்படைக் கணிதத்தைக் கண்டுபிடிக்கவில்லை; அதைப் பயன்படுத்தும் செலவைக் குறைத்தன. (TensorFlow paper; PyTorch paper.)
21. Compression உம் edge AI உம்
Pruning, quantisation, distillation, திறமையான கட்டமைப்பு வடிவமைப்பு ஆகியவை கட்டுப்படுத்தப்பட்ட வன்பொருளில் மேலும் பல models ஐ இயக்க அனுமதிக்கின்றன. Edge இயக்கம் latency ஐக் குறைத்து சில தரவை உள்ளூரிலேயே வைக்கலாம்; ஆனால் தனியுரிமை telemetry, சேமிப்பு, அனுமதிகள், சுற்றியுள்ள application ஐயும் சார்ந்தது.
நான்கு-bit சேமிப்பு, 16-bit சேமிப்பின் மூல weight bits இல் நான்கில் ஒரு பங்கைப் பயன்படுத்துகிறது. Scales, quantise செய்யப்படாத கூறுகள், caches, runtime மேலதிகச் சுமையைக் கணக்கிட்டால் உண்மையான நினைவகச் சேமிப்பு சிறியது. குறைந்த precision விகிதாசார வேக அதிகரிப்புக்கு உத்தரவாதம் தருவதில்லை: வன்பொருள் kernels உம் நினைவக நடத்தையும் முக்கியம்.
GPTQ உம் AWQ உம் post-training quantisation அணுகுமுறைகள். AWQ, முக்கியமான weights ஐ scaling மூலம் பாதுகாக்க activation தகவலைப் பயன்படுத்துகிறது; அதை வெறுமனே 1% weights ஐ முழு precision இல் வைத்திருப்பதாக விவரிக்கக் கூடாது. GGUF ஒரு model கோப்பு வடிவம்; quantisation algorithm அல்ல. (GPTQ; AWQ.)
BitNet b1.58 ternary weights ஐ ஆராய்கிறது; அவை வழக்கமாக −1, 0, +1 ஆகிய மூன்று மதிப்புகளால் குறிக்கப்படுகின்றன. பெயர் log₂(3), அதாவது ஒரு ternary மதிப்புக்கு ஏறத்தாழ 1.58 bits தகவலைப் பிரதிபலிக்கிறது; அமைப்பில் சேமிக்கப்படும் ஒவ்வொரு எண்ணும் செயல்பாடும் சரியாக 1.58 பௌதிக bits ஐப் பயன்படுத்துகிறது என்ற வாக்குறுதி அல்ல.
Speculative decoding, உருவாக்கத்தை விரைவுபடுத்த சிறிய draft செயல்முறையையும் இலக்கு model இன் சரிபார்ப்பு நடைமுறையையும் பயன்படுத்துகிறது. சரியாக வடிவமைக்கப்பட்ட algorithms இலக்கு distribution ஐப் பாதுகாக்க முடியும்; ஆனால் உண்மையான இலாபம் ஏற்பு விகிதங்கள், model அளவுகள், வன்பொருளைப் பொறுத்தது. (Leviathan and colleagues.)
22. அறிவியலுக்கான deep learning
Graph neural networks, neural செயலாக்கத்தை nodes, edges க்குப் பொதுமைப்படுத்தி, மூலக்கூறுகள், பொருட்கள், பிற உறவுக் கட்டமைப்புகளை ஆதரிக்கின்றன. அவற்றின் வரலாறு அண்மைய generative-AI அலைக்கு முந்தையது. (Scarselli and colleagues, 2009; Graph convolutional networks.)
AlphaFold2 புரதக் கட்டமைப்புக் கணிப்பைக் கணிசமாக முன்னேற்றியது. AlphaFold3, diffusion அடிப்படையிலான அணுகுமுறையைப் பயன்படுத்தி, புரதங்கள், நியூக்ளிக் அமிலங்கள், சிறு மூலக்கூறுகள், பிற கூறுகளுக்கு இடையிலான இடைவினைகளுக்கு எல்லையை விரிவாக்கியது. கட்டமைப்புக் கணிப்புகள் ஆய்வுக்கு ஆதரவளிக்கின்றன; பரிசோதனைகளுக்கு மாற்றாகாது; முன்மொழியப்பட்ட மருந்து பயனுள்ளது அல்லது பாதுகாப்பானது என்பதையும் நிறுவாது. (AlphaFold2; AlphaFold3.)
GraphCast வானிலை முன்னறிவிப்புக்குக் கற்ற graph அடிப்படையிலான மாதிரியாக்கத்தைப் பயன்படுத்தியது. GenCast நிகழ்தகவு ensemble அணுகுமுறையை உருவாக்கியது. Lead times, இயக்க நேரம், ஒப்பீட்டுக் கூற்றுகள் அமைப்புக்கும் பரிசோதனைக்கும் ஏற்ப மாறுபடும்; ஆகவே அவற்றை ஒரே உலகளாவிய செயல்திறன் எண்ணாக இணைக்கக் கூடாது. (GraphCast; GenCast.)
GNoME பொருட்கள் கண்டுபிடிப்புக்கு graph networks, active learning ஐப் பயன்படுத்தியது. அதன் மில்லியன் கணக்கான கணிக்கப்பட்ட candidate கட்டமைப்புகளை, மில்லியன் கணக்கான பரிசோதனையில் தொகுக்கப்பட்ட பொருட்களுடனோ சரிபார்க்கப்பட்ட உற்பத்திச் செய்முறைகளுடனோ குழப்பிக்கொள்ளக் கூடாது. (GNoME.)
Physics-informed neural networks உம் கற்ற அறிவியல் surrogates உம் மற்றொரு இழையைச் சேர்க்கின்றன: பௌதிகக் கட்டுப்பாடுகளைக் கற்றலுடன் இணைத்தல் அல்லது செலவான simulations ஐ தோராயமாக்குதல். அவற்றின் நம்பகத்தன்மை இன்னும் அனுமானங்கள், எல்லை நிபந்தனைகள், பயிற்சி உள்ளடக்கம், validation ஐச் சார்ந்தது. (Physics-informed neural networks.)
23. Federated உம் continual learning உம்
Federated learning, அடிப்படை வடிவமைப்பில் மூலத் தரவை உள்ளூரிலேயே வைத்துக்கொண்டு, பகிரப்பட்ட தரவு வைத்திருப்போர் முழுவதும் பயிற்றுவிக்கிறது. FedAvg பங்கேற்கும் clients இன் model புதுப்பிப்புகளைத் திரட்டுகிறது. புதுப்பிப்புகள் இன்னும் தகவலைக் கசியவிடலாம்; ஆகவே தனியுரிமை தானாக அமைவதில்லை. Secure aggregation உம் differential privacy உம் தங்கள் சொந்த அனுமானங்களும் சமரசங்களும் கொண்ட கூடுதல் வழிமுறைகள். (FedAvg; Deep Leakage from Gradients.)
Continual learning, முந்தைய திறன்களை இழக்காமல் புதியவற்றைப் பெற முயல்கிறது. Replay, regularisation, கட்டமைப்புப் பிரிப்பு ஆகியவை முக்கிய அணுகுமுறைகள். Elastic Weight Consolidation, முந்தைய பணிகளுக்கு முக்கியம் என மதிப்பிடப்பட்ட parameters இன் மாற்றங்களுக்கு அபராதம் விதிக்கிறது. LoRA, அடிப்படை weights ஐ உறைநிலையில் வைத்து low-rank புதுப்பிப்புகளைப் பயிற்றுவித்து, தகவமைப்புச் செலவைக் குறைக்கிறது. இரண்டில் எதுவும், விளைந்த model இன் நடத்தை ஒவ்வொரு பழைய திறனையும் தக்கவைக்கும் என உத்தரவாதம் தருவதில்லை. (EWC; LoRA.)
வெளி நினைவகமும் retrieval உம், ஒரு உதவியாளரின் neural weights ஐத் தொடர்ந்து மீளப் பயிற்றுவிக்காமலே அதன் அணுகக்கூடிய தகவலைப் புதுப்பிக்க முடியும். ஆகவே “ஒரு புதிய உண்மையைக் கற்றல்” என்பது model மட்டத்திலும் system மட்டத்திலும் வெவ்வேறு பொருள் தரலாம்.
24. Neuromorphic, neuro-symbolic திசைகள்
Neuromorphic computing உம் spiking networks உம்
Spiking neural networks வழக்கமான dense activation மதிப்புகளை மட்டுமன்றி, காலத்தைச் சார்ந்த நிகழ்வுகளைப் பயன்படுத்துகின்றன. Neuromorphic வன்பொருள், நிகழ்வு-இயக்கச் செயலாக்கத்தையும் நினைவகத்தைக் கணிப்புக்கு அருகில் கொண்டுவருவதையும் ஆராய்கிறது. Intel இன் Loihi ஆய்வு ஒரு முக்கிய எடுத்துக்காட்டு. Event cameras வழக்கமான முழு frames க்குப் பதிலாக, பிரகாச மாற்றங்களின் அரிதான ஓட்டங்களை வழங்கலாம்.
பொருத்தமான வேலைச்சுமிகளுக்கு இந்த அணுகுமுறைகள் சக்தி அல்லது latency நன்மைகளைத் தரலாம்; ஆனால் “அமைதியாக இருக்கும்போது சக்தி பூச்சியம்” என்பது உண்மை வன்பொருளின் முழுமையான கணக்கீடு அல்ல. IBM NorthPole மூளையால் ஊக்கம் பெற்ற மற்றொரு வடிவமைப்பு; ஆனால் அதை Loihi போன்ற அதே வகை spiking processor ஆகக் கருதக் கூடாது.
Neuro-symbolic AI உம் formal verification உம்
Neuro-symbolic அமைப்புகள் கற்ற models ஐ வெளிப்படையான காரணப்படுத்தல், கட்டுப்பாடுகள் அல்லது குறியீட்டுக் கருவிகளுடன் இணைக்கின்றன. Neural கூறுகள் கட்டமைப்புகளை அல்லது formal கூற்றுகளை முன்மொழியலாம்; Lean போன்ற proof assistants உம் Z3 போன்ற SMT solvers உம் குறிப்பிட்ட கணிதப் பண்புகளைச் சரிபார்க்க முடியும். சரிபார்ப்பு உத்தரவாதங்கள் formalisation ஐயும் கருவி அமைப்பையும் பொறுத்தவை.
AlphaGeometry உம் பிற்கால AlphaProof/AlphaGeometry 2 வேலையும் இந்தத் திசையை விளக்குகின்றன. அறிவிக்கப்பட்ட 2024 International Mathematical Olympiad முடிவு, குழுவின் பரிசோதனை அமைப்பின் கீழ் வெள்ளிப் பதக்கத் தரச் செயல்திறன்; தன்னாட்சி போட்டியாளர் வென்ற அதிகாரபூர்வப் பதக்கம் அல்ல. (AlphaGeometry; 2024 ஆய்வு அறிக்கை.)
Formal verification, formal கூற்றுகள், axioms, அனுமானங்கள், நம்பப்படும் சரிபார்ப்பு அமைப்பு ஆகியவற்றுடன் ஒப்பிட்டு ஒரு பண்பை நிரூபிக்கிறது. ஒரு முறைசாரா கோரிக்கை சரியாக மொழிபெயர்க்கப்பட்டது, தொடர்புடைய எல்லா நிஜ உலக நிலைமைகளும் மாதிரியாக்கப்பட்டன, அல்லது ஒரு program இல் சாத்தியமான பாதுகாப்புப் பலவீனம் எதுவும் இல்லை என்பதற்கு அது உத்தரவாதம் தர முடியாது. ஆகவே “hallucination-அற்ற செயலுக்கு உத்தரவாதம்” என்பது பொருத்தமான பொதுக் கூற்று அல்ல.
25. நடைமுறைக் கற்றல் வழித்தடம்
சில வரி code ஒரு frontier ஆய்வு அமைப்பை மீளுருவாக்க முடியும் என நடிக்காமல், பின்வரும் பயிற்சிகள் ஒரு நடைமுறைத் திசையைத் தருகின்றன.
பயிற்சி A: சிறிய neural network மூலம் XOR ஐக் கற்றல்
நான்கு உள்ளீட்டுச் சோடிகளைப் பயன்படுத்துங்கள்: (0,0), (0,1), (1,0), (1,1); இலக்குகள் 0,1,1,0. ஒரே நேரியல் classifier அவற்றைப் பிரிக்க முடியாது. nonlinear மறைந்த layer கொண்ட network அந்த உறவைக் குறிக்க முடியும்.
பொருத்தமான கற்றல் பயிற்சி:
- 2-உள்ளீடு, 8-மறைந்த-அலகு, 1-வெளியீடு network ஐ உருவாக்குங்கள்.
- மறைந்த layer இல் nonlinear activation ஐப் பயன்படுத்துங்கள்.
- வெளியீட்டு logits இலிருந்து வகைப்படுத்தல் loss ஐக் கணக்கிடுங்கள்.
- முந்தைய gradients ஐ அழியுங்கள், forward pass ஐ ஓட்டுங்கள், backpropagate செய்யுங்கள், optimiser படியை எடுங்கள்.
- கணிப்புகளையும் loss ஐயும் அச்சிடுங்கள்; பின்னர் பல சீரற்ற seeds இல் மீண்டும் செய்யுங்கள்.
ஒவ்வொரு initialisation க்கும் தன்னிச்சையான பயிற்சி budget க்கும் பயிற்சி வெற்றி உத்தரவாதமில்லை. ReLU 2012 இல் கண்டுபிடிக்கப்படவில்லை; Adam 1986 backpropagation கட்டுரையின் பகுதியும் அல்ல. நவீனப் பயிற்சி வெவ்வேறு காலங்களின் யோசனைகளை இணைக்கிறது. (PyTorch autograd tutorial.)
import torch
from torch import nn
torch.manual_seed(7)
X = torch.tensor([[0., 0.], [0., 1.],
                  [1., 0.], [1., 1.]])
y = torch.tensor([[0.], [1.], [1.], [0.]])
model = nn.Sequential(nn.Linear(2, 8), nn.Tanh(),
                      nn.Linear(8, 1))
loss_fn = nn.BCEWithLogitsLoss()
optimiser = torch.optim.Adam(model.parameters(), lr=0.03)
for step in range(2000):
    optimiser.zero_grad()
    loss = loss_fn(model(X), y)
    loss.backward()
    optimiser.step()
with torch.no_grad():
    probabilities = torch.sigmoid(model(X))
    predictions = (probabilities >= 0.5).int()
print(probabilities)
print(predictions)  # Compare with the target: 0, 1, 1, 0.
இந்த விளக்க எடுத்துக்காட்டுக்கு PyTorch தேவை. முடிவுகளை உங்கள் சூழலில் சரிபாருங்கள்; seed அமைப்பது மீளுருவாக்கத்தை மேம்படுத்தும்; ஆனால் எல்லா மென்பொருள், வன்பொருள் அமைப்புகளிலும் ஒரே நடத்தைக்கு உத்தரவாதம் தராது.
பயிற்சி B: LoRA அல்லது QLoRA மூலம் ஒரு model ஐத் தகவமைத்தல்
உரிமமும் வன்பொருள் தேவைகளும் பணிக்குப் பொருந்தும் ஒரு model ஐத் தெரிவுசெய்யுங்கள். சிறிய, கவனமாக மீளாய்வு செய்த தரவுத்தொகுதியுடனும் ஒதுக்கிவைத்த மதிப்பீட்டுத் தொகுதியுடனும் தொடங்குங்கள். LoRA சுருக்கமான low-rank புதுப்பிப்புகளைப் பயிற்றுவிக்கிறது. QLoRA, உறைநிலையில் உள்ள quantised அடிப்படை model வழியாக adapters க்குள் backpropagate செய்கிறது. நினைவகத் தேவைகள் parameter எண்ணிக்கையை மட்டுமன்றி context நீளம், batch அளவு, optimiser, கட்டமைப்பு, செயலாக்கத்தையும் பொறுத்தவை. (QLoRA.)
இலக்குத் திறனையும், ஏற்கனவே உள்ள திறன்களில் ஏற்படும் பின்னடைவுகளையும் அளவிடுங்கள். Quantisation உம் உறைந்த weights உம் முந்தைய நடத்தை அனைத்தும் பாதுகாக்கப்படும் என உத்தரவாதம் தருவதில்லை.
பயிற்சி C: சிறிய RAG உதவியாளரை உருவாக்குதல்
வரையறுக்கப்பட்ட, அனுமதி பெற்ற ஆவணத் தொகுப்பை உள்ளிடுங்கள்; அதைப் பொருள்தரும் chunks ஆகப் பிரியுங்கள்; embeddings ஐ உருவாக்குங்கள்; candidate சான்றை retrieve செய்யுங்கள்; விருப்பமானால் rerank செய்யுங்கள்; தடமறியக்கூடிய மேற்கோள்களுடன் பதில்களை உருவாக்குங்கள். “500-token chunks உம் முதல் மூன்று முடிவுகளும்” என்பதை உலகளாவிய உகந்த அமைப்புகளாக அல்ல, தொடக்கப் பரிசோதனைகளாகக் கருதுங்கள்.
அறிந்த பதில்களுடன் கேள்விகள், பல ஆவணங்கள் தேவைப்படும் கேள்விகள், முரண்படும் ஆவணங்கள், தொகுப்பு பதிலளிக்க முடியாத கேள்விகளைச் சோதியுங்கள். மேற்கோள் துல்லியத்தையும், சான்று போதாது என்று உதவியாளர் சொல்ல முடியுமா என்பதையும் சரிபாருங்கள். இரகசியத் தகவலை ஒரு index இல் வைப்பதற்கு முன் அணுகல் கட்டுப்பாடுகளைச் சேருங்கள்.
26. இன்னும் தீர்க்கப்படாதவை
- Generalisation: வலுவான benchmark புள்ளிகள், புதிய distributions அல்லது உண்மையிலேயே பழக்கமற்ற பணிகளில் உறுதியான செயல்திறனை நிறுவுவதில்லை.
- Sample efficiency: அமைப்புகளுக்குப் பெரும்பாலும் மனிதர்களை விட மிக அதிகத் தரவு அல்லது இடைவினை தேவை; ஆனால் எளிமையான ஒப்பீடுகள் மனிதரின் முந்தைய அனுபவத்தையும் வேறுபடும் பணிகளையும் புறக்கணிக்கின்றன.
- Reliability: hallucinations, tool பிழைகள், குறைபாடுள்ள சரிபார்ப்பு ஆகியவை நீண்ட workflows இல் பெருகலாம்.
- Causality உம் பௌதிகப் புரிதலும்: உலகின் முழுமையான காரண model ஐத் தராமலே கணிப்பு பயனுள்ளதாக இருக்கலாம்.
- Interpretability: பயனுள்ள கண்டுபிடிப்புகள் இன்னும் பெரிய models பற்றிய முழுமையான புரிதலாகவில்லை.
- தனியுரிமையும் பாதுகாப்பும்: பயிற்சித் தரவு, model வெளியீடுகள், புதுப்பிப்புகள், tool இணைப்புகள் வெவ்வேறு வெளிப்பாட்டு அபாயங்களை உருவாக்குகின்றன.
- Efficiency: parameter எண்ணிக்கையுடன் நினைவகம், சக்தி, தொடர்பாடல், நீர்ப் பயன்பாடு, வன்பொருள் செலவு அனைத்தும் முக்கியம்.
- Evaluation: contamination, benchmark நிறைவு, நடுவர் சார்பு, மோசமான நிஜ உலக அளவீடு ஆகியவை உண்மையான முன்னேற்றத்தை மறைக்கலாம்.
- Alignment உம் ஆளுகையும்: யாருடைய விருப்பங்கள் கற்கப்படுகின்றன, முரண்பாடுகள் எப்படிக் கையாளப்படுகின்றன, யார் பொறுப்புக்கூறுபவராக இருக்கிறார் என்பவை முற்றிலும் கட்டமைப்புக் கேள்விகள் அல்ல.
ARC benchmark திறன் பெறுதலையும் சுருக்கமாக்கலையும் ஆராய அறிமுகப்படுத்தப்பட்டது; ஆனால் எந்த ஒரு benchmark உம் நுண்ணறிவை வரையறுப்பதில்லை. முடிவுகள் தொடர்புடைய பதிப்பு, மதிப்பீட்டு நிலைமைகளின் கீழ் விளக்கப்பட வேண்டும். (Chollet, On the Measure of Intelligence.)
விளக்கமான நம்பகத்தன்மைக் கணக்கீட்டுக்கு: 100 படிகள் ஒவ்வொன்றும் 0.99 நிகழ்தகவுடன் சுயாதீனமாக வெற்றிபெறும்; ஒவ்வொரு படியும் வெற்றிபெற வேண்டும் எனில், மொத்த வெற்றியின் நிகழ்தகவு 0.99¹⁰⁰, ஏறத்தாழ 36.6%. உண்மை workflows இல் சார்புகள், மீள்முயற்சிகள், மீட்பு உள்ளன; ஆகவே இந்தக் கணக்கீடு இணைப்பு பற்றிய எச்சரிக்கை; ஒவ்வொரு agent க்குமான அனுபவ முன்கணிப்பு அல்ல.
27. வரலாற்றின் மையப் பாடம்
Deep learning பல கூறுகள் ஒன்றுசேர்ந்தபோது முன்னேறியது: கற்கக்கூடிய representations, பயனுள்ள objectives, செயல்படக்கூடிய optimisation, போதுமான தரவு, நடைமுறை வன்பொருள், திறமையான மென்பொருள், அர்த்தமுள்ள மதிப்பீடு.
இந்த வரலாற்றில் புகழ்பெற்ற தனிநபர்கள் உள்ளனர்; ஆனால் இது ஒரு நபர், நிறுவனம், நாடு அல்லது கட்டமைப்பின் சாதனை அல்ல. Backpropagation, CNN கள், LSTM கள், CUDA, ImageNet, attention, Transformers, generative modelling, reinforcement learning, systems engineering ஒவ்வொன்றும் பிரச்சினையின் வெவ்வேறு பகுதிகளைத் தீர்த்தன.
அடுத்த அத்தியாயம் வெறுமனே “பெரிய models” அல்ல. அது சிறந்த தரவு, திறமையான கணிப்பீடு, வலுவான சரிபார்ப்பு, multimodal புரிதல், பயனுள்ள பௌதிக இடைவினை, benchmark ஐ விட்டு நிஜ வாழ்க்கைக்குள் நுழையும்போதும் நம்பகமாக இருக்கும் அமைப்புகளை உள்ளடக்குகிறது.
இணைப்பு A. கற்றல் வழித்தடம்
நிலை 1: கணித, நிரலாக்க அடித்தளங்கள். Linear algebra, derivatives உம் chain rule உம், நிகழ்தகவு, optimisation, Python, அடிப்படை tensor செயல்பாடுகள்.
நிலை 2: மைய neural கற்றல். MLP கள், loss functions, backpropagation, train/validation/test பிரிப்பு, regularisation, CNN கள், RNN கள், LSTM கள்.
நிலை 3: Attention உம் representation கற்றலும். Embeddings, self-attention, நிலைத் தகவல், Transformers, self-supervised learning, generative models, multimodal representations.
நிலை 4: அளவும் திறனும். Distributed training, mixed precision, KV caches, திறமையான attention, MoE, state-space models, compression, edge deployment.
நிலை 5: தகவமைப்பும் reasoning உம். SFT, LoRA/QLoRA, விருப்ப optimisation, reinforcement learning, distillation, process/outcome rewards, test-time கணிப்பீடு.
நிலை 6: அமைப்புகளும் பொறுப்பான deployment உம். RAG, tool பயன்பாடு, agents, மதிப்பீடு, பாதுகாப்பு, தனியுரிமை, interpretability, ரோபோட்டிக்ஸ், formal verification.
இணைப்பு B. விரைவுக் குறிப்புச் சொற்களஞ்சியம்
- Activation: ஒரு neural கூறின் எண் பதில்; அத்தகைய பதில்களை உருவாக்கும் nonlinear function உம்.
- Backpropagation: chain rule ஐப் பயன்படுத்தி ஒரு computational graph வழியாகத் திறமையாக derivative ஐக் கணக்கிடுதல்.
- CNN: convolutional செயல்பாடுகளையும் பகிரப்பட்ட உள்ளூர் filters ஐயும் பயன்படுத்தும் network.
- Embedding: token, படம் அல்லது graph node போன்ற ஒன்றின் கற்ற vector representation.
- Foundation model: பல downstream பயன்பாடுகளுக்குத் தகவமைக்கக்கூடிய, பரந்த அளவில் முன்பயிற்றுவிக்கப்பட்ட model.
- Gradient: parameters உடன் ஒரு அளவு எப்படி மாறுகிறது என்பதைக் காட்டும் derivatives.
- GRPO: DeepSeekMath இல் அறிமுகமான group-relative policy-optimisation முறை.
- Inference: பயிற்றுவித்த model ஐப் பயன்படுத்தி வெளியீடுகளை உருவாக்குதல்.
- KV cache: autoregressive decoding இன்போது மீளப் பயன்படுத்தப்படும் சேமித்த key/value representations.
- LoRA: பெரும்பாலும் உறைந்த model ஐத் தகவமைக்கப் பயன்படும் low-rank பயிற்றுவிக்கக்கூடிய புதுப்பிப்புகள்.
- LSTM: கட்டமைக்கப்பட்ட நினைவகப் பாதைகளும் gates உம் கொண்ட recurrent கட்டமைப்பு.
- MoE: உள்ளீடுகளைத் தெரிவுசெய்த expert subnetworks க்கு அனுப்பும் நிபந்தனைக் கணிப்பீடு.
- Multimodal: text, படங்கள் போன்ற ஒன்றுக்கு மேற்பட்ட சமிக்ஞை வகைகளை உள்ளடக்கியது.
- Optimiser: gradients அல்லது தொடர்புடைய தகவலைப் பயன்படுத்தி parameters ஐப் புதுப்பிக்கும் algorithm.
- Quantisation: எண் மதிப்புகளைக் குறைந்த மட்டங்கள் அல்லது குறைந்த precision உடன் குறிப்பிடுதல்.
- RAG: retrieve செய்த வெளிப் பொருளால் வழிநடத்தப்படும் உருவாக்கம்.
- RLHF: மனிதக் கருத்தால் வடிவமைக்கப்படும் reinforcement learning.
- Self-attention: representation தொடர்வரிசையில் நிலைகளுக்கு இடையிலான தகவலுக்கு கற்ற எடையிடல்.
- Sparse autoencoder: அரிதாகச் செயல்படும் representation வழியாக உள்ளீடுகளை மீளுருவாக்கும் model; interpretability ஆய்வு உட்பட பலவற்றில் பயன்படுகிறது.
- State-space model: மாறும் உள் state இன் model; நவீன neural பதிப்புகள் தொடர்வரிசைகளைத் திறமையாகச் செயலாக்க முடியும்.
- Synthetic data: இறுதி வடிவில் நேரடியாகச் சேகரிக்கப்படாமல், ஒரு model, simulator அல்லது பிற generative செயல்முறையால் உருவாக்கப்பட்ட எடுத்துக்காட்டுகள்.
- Test-time compute: ஒரு குறிப்பிட்ட பிரச்சினையைப் பெற்ற பின் ஒதுக்கப்படும் கணிப்பீடு; கூடுதல் உருவாக்கம், search அல்லது சரிபார்ப்பு உட்பட.
- Token: model உள்ளீடு அல்லது வெளியீட்டு representation இன் அலகு; அது முழுச் சொல்லாக இருக்க வேண்டியதில்லை.
- World model: சூழல் இயக்கவியலின் கற்ற representation அல்லது predictor; செயல்களைச் சார்ந்ததாகவும் இருக்கலாம்.