ResNet Skip Connections மற்றும் Vision Transformer: படத்திலிருந்து டோக்கன் வரை எளிய விளக்கம்
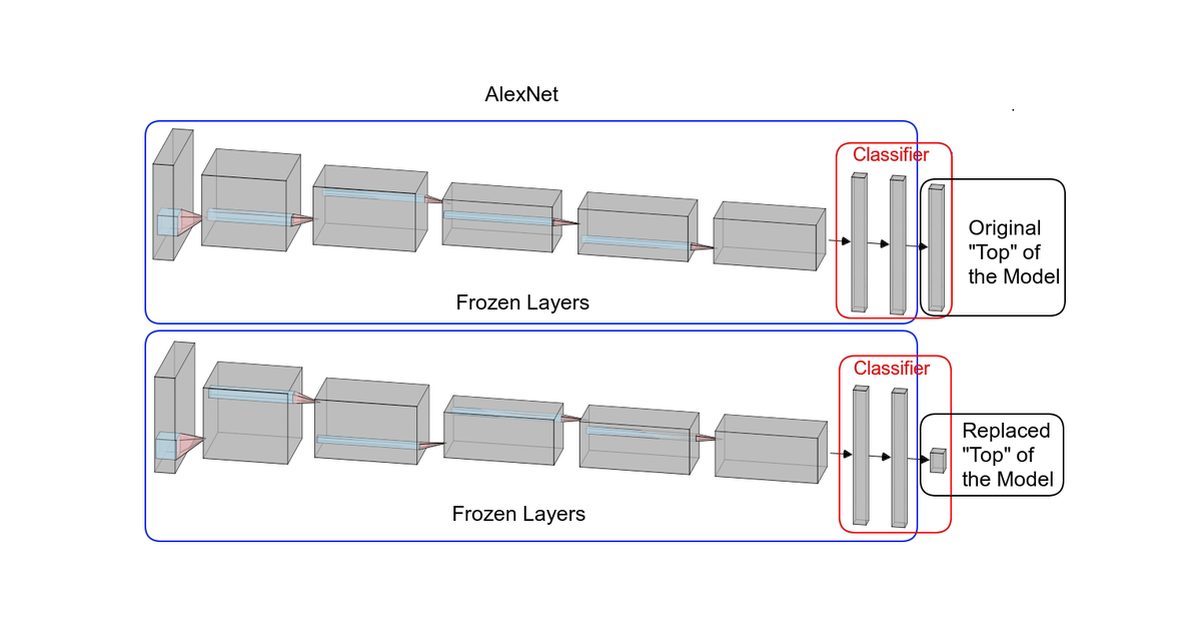
AlexNet அடுக்குகளை அடிப்படையாகக் கொண்ட convolutional வலையமைப்பின் வரைபடம் (classifier மாற்றப்பட்டது); விளக்கப் படம், 2012 மூலக் கட்டமைப்பு அல்ல. வரைபடம்: Daniel Voigt Godoy, CC BY 4.0, Wikimedia Commons வழியாக.
ஆழ்கற்றல் வரலாற்றில் இரண்டு மிக முக்கியமான கணிதத் திருப்புமுனைகளான ResNet-இன் Skip Connections மற்றும் Vision Transformer-இன் Image-to-Token மாற்றம் ஆகிய இரண்டும் எவ்வாறு செயல்படுகின்றன என்பதை எளிமையாகப் பார்க்கலாம்.
1. ResNet-இன் Skip Connections (கணித விளக்கம்)
வழக்கமான நரம்பியல் வலையமைப்புகளில், ஒரு உள்ளீடு x பல அடுக்குகள் வழியாகச் செல்லும்போது H(x) என்ற வெளியீட்டைத் தருகிறது. அடுக்குகள் அதிகமாகும்போது, சாய்வுகள் (Gradients) பூஜ்ஜியத்தை நோக்கிச் சுருங்கி பயிற்சி நின்றுவிடும் (Vanishing Gradient Problem).
ResNet இதை மாற்றியமைத்தது. அடுக்குகளை நேரடியாக H(x) கற்றுக்கொள்ள வைப்பதற்குப் பதிலாக, உள்ளீட்டிற்கும் வெளியீட்டிற்கும் இடையே உள்ள வித்தியாசத்தை (Residual) மட்டும் கற்றுக்கொள்ள வைக்கிறது:
F(x) = H(x) − x
இதை மாற்றி எழுதினால், ஒரு ResNet தொகுதியின் வெளியீடு y கீழ்க்கண்டவாறு அமையும்:
y = F(x, {Wᵢ}) + x
- x: உள்ளீடு (Input).
- F(x, {Wᵢ}): கன்வல்யூஷன் அடுக்குகள் கற்றுக்கொள்ளும் எச்சச் சார்பு (Residual Mapping).
- + x: இதுவே Identity Skip Connection. உள்ளீட்டை எந்த மாற்றமும் இல்லாமல் நேரடியாக வெளியீட்டுடன் கூட்டுகிறது.
பின்னோக்கிய பரவலில் (Backpropagation) இதன் மாயம்:
பயிற்சியின் போது பிழையை (Loss L) பின்னோக்கி அனுப்பும்போது, சங்கிலி விதியின்படி (Chain Rule) சாய்வு (Gradient) இவ்வாறு கணக்கிடப்படுகிறது:
∂L/∂x = ∂L/∂y · ∂y/∂x = ∂L/∂y · (∂F/∂x + 1)
- ஏன் சாய்வு மறைவதில்லை? அடைப்புக்குறிக்குள் உள்ள + 1 காரணமாக, ∂F/∂x மதிப்பு மிகவும் சிறியதாக மாறினாலும், பிழைச் சாய்வு ∂L/∂y தடையின்றி நேரடியாக ஆரம்ப அடுக்குகளுக்குப் பாய்கிறது.
- அளவுகள் மாறினால் (Dimension Mismatch): F(x) மற்றும் x ஆகியவற்றின் பரிமாணங்கள் (Channels/Size) மாறுபட்டால், x-ஐ நேரியல் உருமாற்றம் (Wₛx) செய்து கூட்டுவார்கள்: y = F(x) + Wₛx.
1. ResNet-இன் Residual Block (PyTorch Code)
இதில் உள்ளீடு x நேரடியாக வெளியீட்டுடன் (out + identity) எவ்வாறு கூட்டப்படுகிறது என்பதைக் கவனிக்கவும்.
import torch
import torch.nn as nn

class ResidualBlock(nn.Module):
    def __init__(self, in_channels: int, out_channels: int, stride: int = 1):
        super().__init__()

        # முதன்மைப் பாதை: F(x)
        self.conv_block = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=3, stride=stride, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),

            nn.Conv2d(out_channels, out_channels, kernel_size=3, stride=1, padding=1, bias=False),
            nn.BatchNorm2d(out_channels)
        )

        # Skip Connection பாதை: x (அளவுகள் மாறினால் 1x1 Conv மூலம் சரிசெய்யப்படும்)
        self.shortcut = nn.Sequential()
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride, bias=False),
                nn.BatchNorm2d(out_channels)
            )

        self.relu = nn.ReLU(inplace=True)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        identity = self.shortcut(x)   # x (அல்லது Ws * x)
        out = self.conv_block(x)      # F(x)

        out = out + identity          # y = F(x) + x (முக்கியமான Skip Connection)
        return self.relu(out)

# --- இயக்கிப் பார்த்தல் ---
if __name__ == "__main__":
    x = torch.randn(4, 64, 56, 56)  # 4 படங்கள், 64 channels, 56x56 அளவு
    block = ResidualBlock(in_channels=64, out_channels=64, stride=1)
    y = block(x)
print(f"ResNet Input: {x.shape} -> Output: {y.shape}")- out = out + identity: இதுதான் பிழைச் சாய்வுகள் (Gradients) மறையாமல் பின்னோக்கிச் செல்ல உதவும் முக்கியப் பாலம்.
2. Vision Transformer (ViT) படங்களை எவ்வாறு டோக்கன்களாக மாற்றுகிறது?
டிரான்ஸ்ஃபார்மர் மாதிரிகள் எழுத்துக்களின் வரிசையை (1D Sequence) மட்டுமே புரிந்துகொள்ளும். எனவே, 2D படங்களை 1D டோக்கன்களாக மாற்ற ViT நான்கு படிநிலைகளைப் பயன்படுத்துகிறது.
படி 1: படத்தைத் துண்டுகளாகப் பிரித்தல் (Patching)
H × W × C (உயரம் × அகலம் × நிறங்கள்) அளவுள்ள ஒரு படம், P × P அளவுள்ள சிறிய சதுரத் துண்டுகளாகப் (Patches) பிரிக்கப்படுகிறது.
- எடுத்துக்காட்டாக, 224 × 224 × 3 படத்தை 16 × 16 துண்டுகளாகப் பிரித்தால்:
N = (224 × 224) / (16 × 16) = 14 × 14 = 196 patches
படி 2: தட்டையாக்குதல் (Flattening)
ஒவ்வொரு 3D துண்டும் (16 × 16 × 3) ஒரு நீளமான ஒற்றை வரிசை வெக்டராக (1D Vector) மாற்றப்படுகிறது:
16 × 16 × 3 = 768 numbers
இப்போது நம்மிடம் 196 × 768 அளவுள்ள தரவு உள்ளது.
படி 3: நேரியல் படமிடல் (Linear Projection / Patch Embedding)
ஒவ்வொரு 768-நீள வெக்டரும், கற்றுக்கொள்ளக்கூடிய ஒரு அணி (Learnable Matrix E) உடன் பெருக்கப்பட்டு, மாதிரியின் நிலையான பரிமாணத்திற்கு (D, பொதுவாக 768) மாற்றப்படுகிறது:
zₚⁱ = xₚⁱ · E
(நடைமுறையில், PyTorch-இல் இதை nn.Conv2d(3, 768, kernel_size=16, stride=16) என்ற ஒரே அடுக்கின் மூலம் மிக வேகமாகச் செய்துவிடுவார்கள்).
படி 4: [CLS] டோக்கன் மற்றும் நிலைக் குறியீடு சேர்த்தல் (Position Embedding)
டிரான்ஸ்ஃபார்மருக்கு எந்தத் துண்டு படத்தின் எந்த இடத்தில் (மேலே, கீழே, நடுவில்) இருந்தது என்று தெரியாது. எனவே இரண்டு விஷயங்கள் சேர்க்கப்படுகின்றன:
- 1. [CLS] Token: படத்தின் ஒட்டுமொத்த அர்த்தத்தைச் சேகரிக்க, 196 துண்டுகளுக்கு முன்னால் ஒரு சிறப்பு டோக்கன் (z_class) சேர்க்கப்படுகிறது. இதனால் மொத்த டோக்கன்கள் 197 ஆகின்றன.
- 2. Position Embeddings (E_pos): ஒவ்வொரு துண்டின் இடத்தையும் குறிக்கும் எண்கள் நேரடியாகக் கூட்டப்படுகின்றன:
Z₀ = [z_class; zₚ¹; zₚ²; …; zₚ¹⁹⁶] + E_pos
இந்த 197 × 768 அளவுள்ள அணிதான் டிரான்ஸ்ஃபார்மர் என்கோடருக்குள் (Transformer Encoder) உள்ளீடாகச் செல்கிறது.
2. Vision Transformer (ViT) Patch Embedding (PyTorch Code)
ஒரு 224 × 224 படத்தை 197 × 768 அளவுள்ள டோக்கன்களாக மாற்றும் முழுமையான செயல்முறை:
import torch
import torch.nn as nn

class ViTPatchEmbedding(nn.Module):
    def __init__(self, img_size: int = 224, patch_size: int = 16, in_channels: int = 3, embed_dim: int = 768):
        super().__init__()
        self.num_patches = (img_size // patch_size) ** 2  # (224 / 16)^2 = 196 துண்டுகள்

        # Conv2d மூலம் படத்தை 16x16 துண்டுகளாகப் பிரித்து 768 பரிமாணத்திற்கு மாற்றுதல்
        self.proj = nn.Conv2d(in_channels, embed_dim, kernel_size=patch_size, stride=patch_size)

        # கற்றுக்கொள்ளக்கூடிய [CLS] டோக்கன் (1 x 1 x 768)
        self.cls_token = nn.Parameter(torch.zeros(1, 1, embed_dim))

        # கற்றுக்கொள்ளக்கூடிய நிலைக் குறியீடுகள் (1 x 197 x 768)
        self.pos_embed = nn.Parameter(torch.zeros(1, self.num_patches + 1, embed_dim))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        batch_size = x.shape[0]

        # 1. துண்டுகளாக்கி படமிடுதல்: (B, 3, 224, 224) -> (B, 768, 14, 14)
        x = self.proj(x)

        # 2. தட்டையாக்கி வரிசைப்படுத்துதல்: (B, 768, 14, 14) -> (B, 768, 196) -> (B, 196, 768)
        x = x.flatten(2).transpose(1, 2)

        # 3. ஒவ்வொரு படத்திற்கும் முன்னால் [CLS] டோக்கனைச் சேர்த்தல்: -> (B, 197, 768)
        cls_tokens = self.cls_token.expand(batch_size, -1, -1)
        x = torch.cat((cls_tokens, x), dim=1)

        # 4. நிலைக் குறியீட்டைக் கூட்டுதல் (Position Embedding)
        x = x + self.pos_embed
        return x

# --- இயக்கிப் பார்த்தல் ---
if __name__ == "__main__":
    img = torch.randn(4, 3, 224, 224)  # 4 RGB படங்கள் (224x224)
    vit_embed = ViTPatchEmbedding(img_size=224, patch_size=16, embed_dim=768)
    tokens = vit_embed(img)
print(f"ViT Image: {img.shape} -> Tokens: {tokens.shape}")- x.flatten(2).transpose(1, 2): இது 14 × 14 கட்டத்தை 196 வரிசை டோக்கன்களாக மாற்றுகிறது.
- torch.cat((cls_tokens, x), dim=1): மொத்த டோக்கன்களின் எண்ணிக்கையை 196-லிருந்து 197-ஆக மாற்றுகிறது.
சுருக்கமான ஒப்பீடு
| அம்சம் | ResNet (Skip Connections) | Vision Transformer (Tokenization) |
|---|---|---|
| அடிப்படை அலகு | பிக்சல்கள் மற்றும் உள்ளூர் வடிவங்கள் (Local Grids) | 16×16 படத் துண்டுகள் (Image Patches) |
| கணிதச் செயல்பாடு | y = F(x) + x (கூட்டல் வழித்தடம்) | Z₀ = [x_class; xₚE] + E_pos (அணிப் பெருக்கல்) |
| இடஞ்சார்ந்த அறிவு (Spatial Sense) | கன்வல்யூஷன் இயல்பாகவே இடத்தை அறியும் | Position Embeddings மூலம் இடத்தைக் கற்றுக்கொள்கிறது |